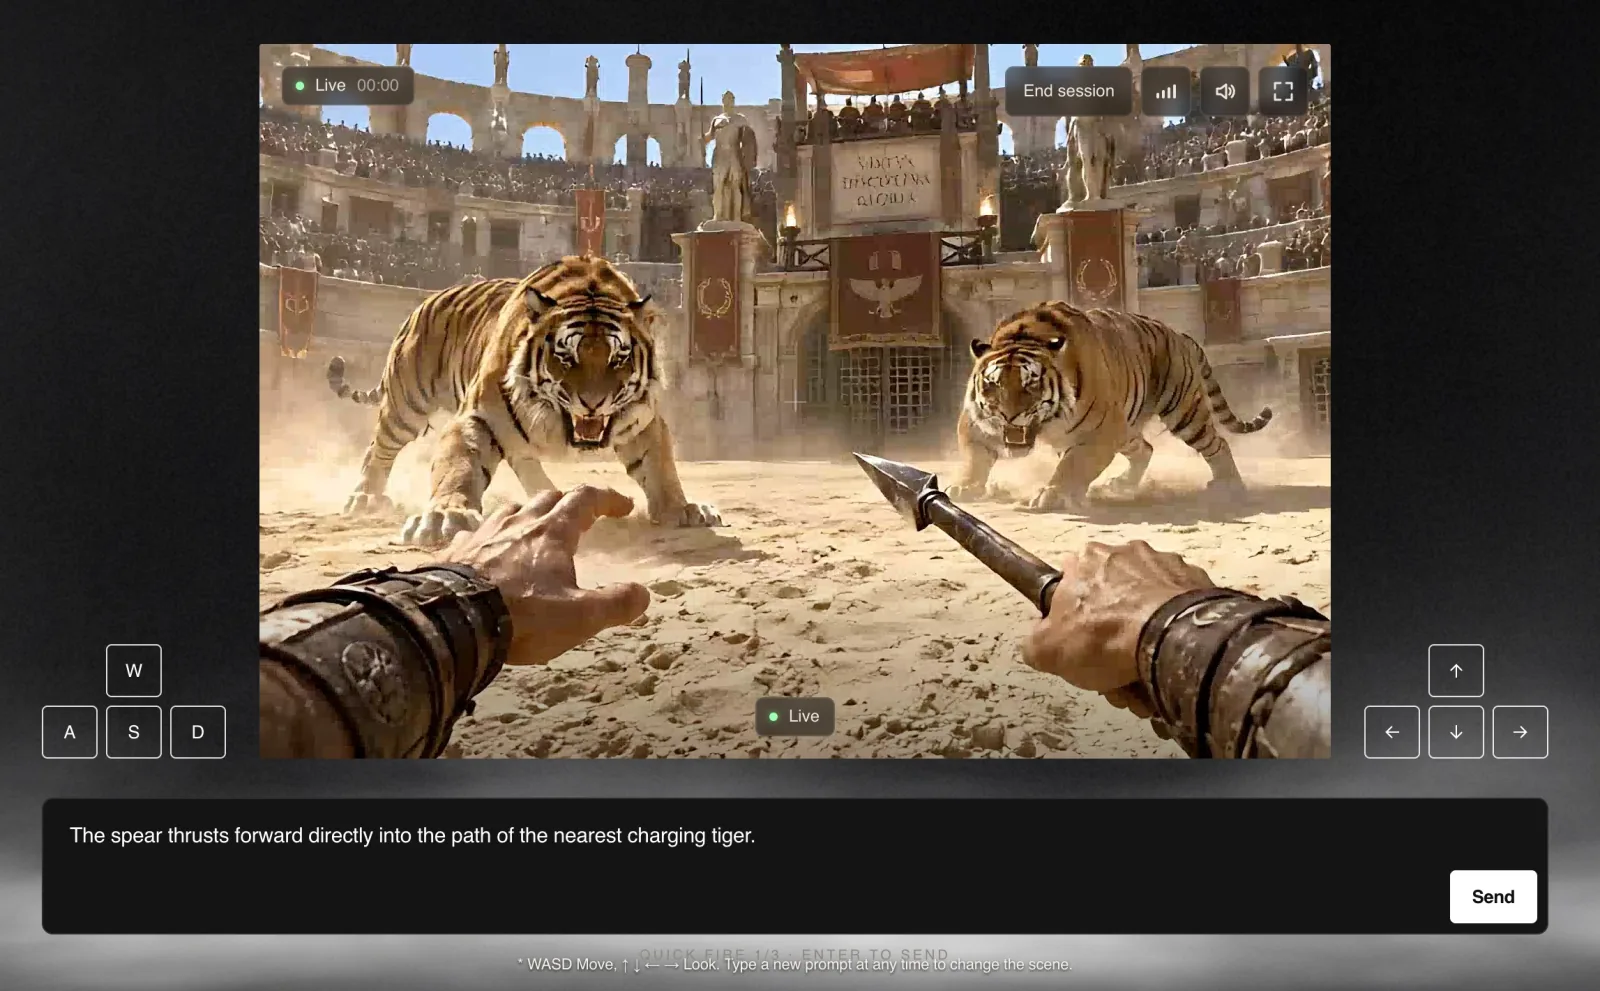
Hoy presentamos Helix World, un modelo de mundo audiovisual interactivo en tiempo real desarrollado por Noiz AI y la Universidad de Ciencia y Tecnología de Hong Kong (HKUST). Partes de una sola imagen, te mueves con WASD y miras alrededor con las flechas. El modelo genera el siguiente tramo de vídeo y el sonido estéreo correspondiente al mismo tiempo, a 24 fotogramas por segundo en una sola GPU NVIDIA H800.
Helix World es un modelo de mundo que genera una escena explorable y su banda sonora estéreo espacial a la vez, condicionado por el movimiento de cámara y las acciones de teclado del usuario. Cuando la cámara gira, el campo sonoro gira con ella.
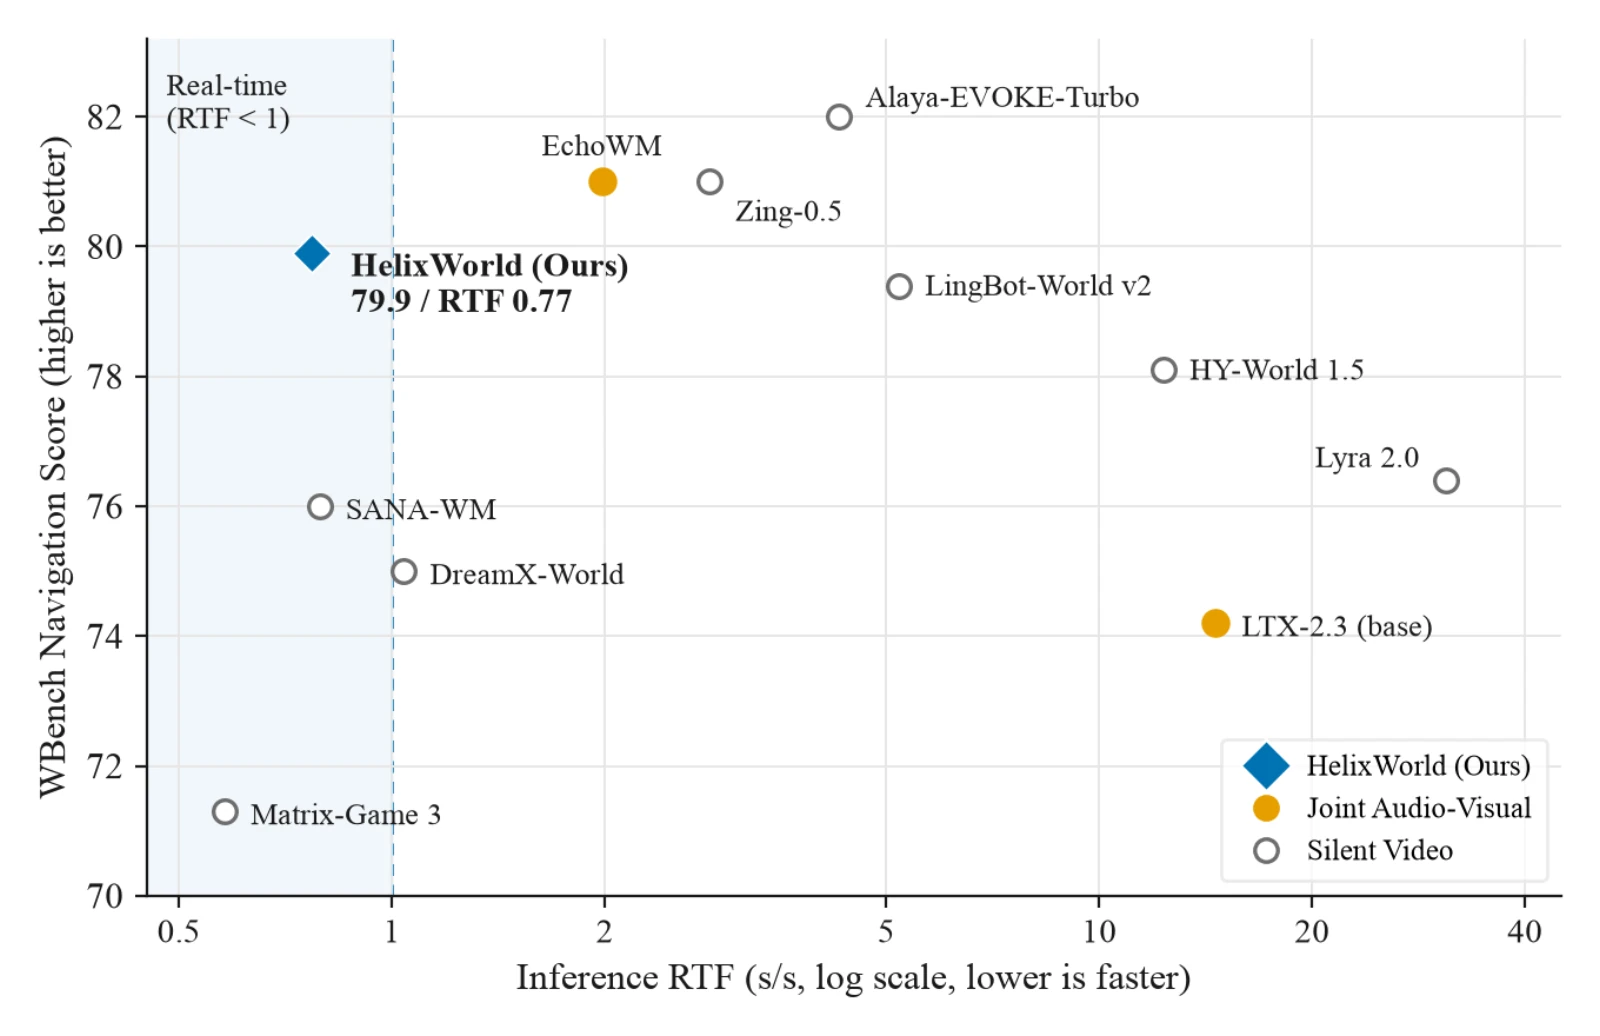
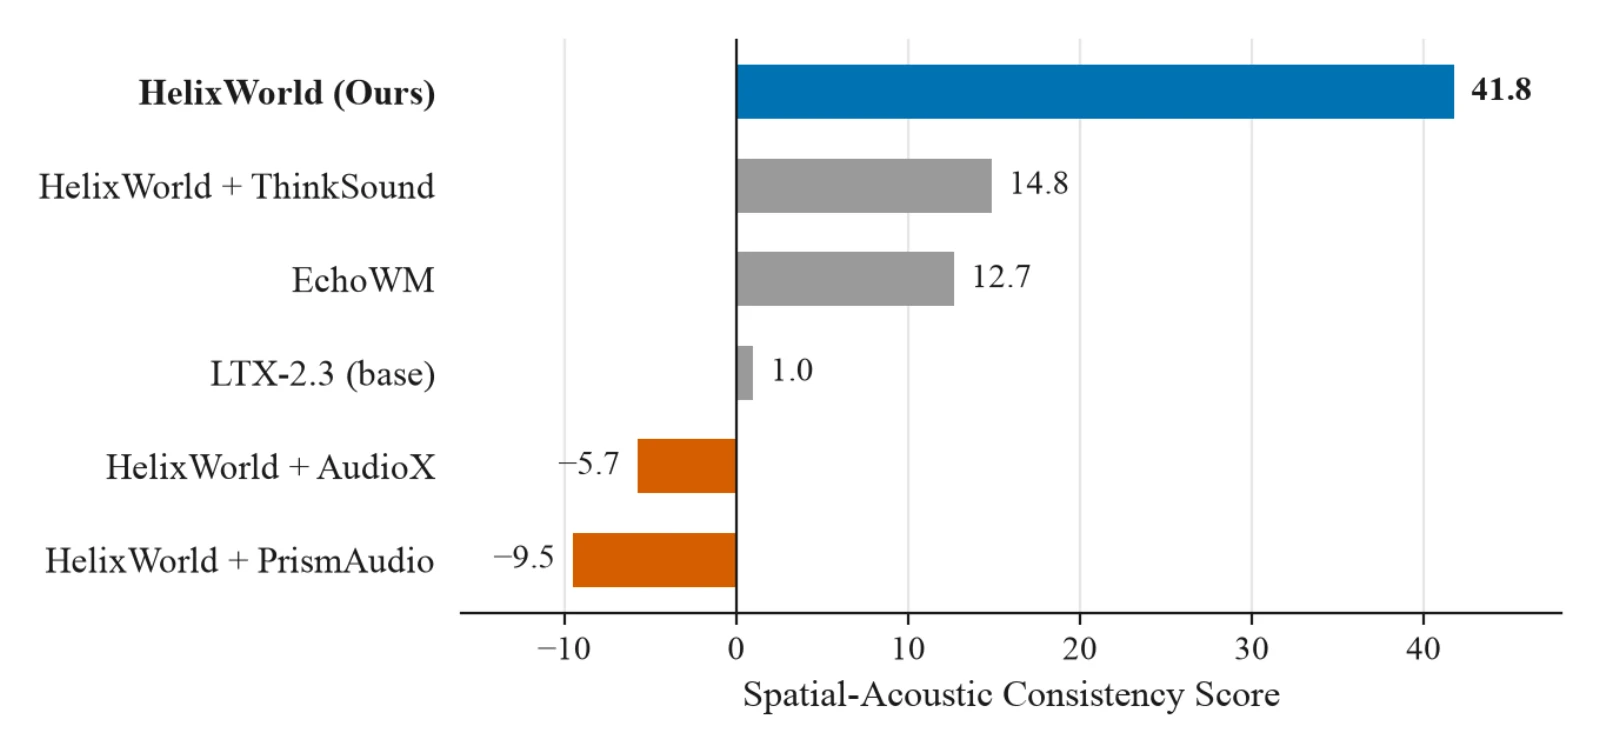
En la partición de navegación de WBench, Helix World obtiene 79,9, cerca de los mejores modelos de mundo sin sonido, y funciona más rápido que el tiempo real, con un factor de tiempo real (RTF) de 0,77. En HelixBench, el benchmark audiovisual que publicamos junto al modelo, su puntuación de coherencia espacial-acústica es 41,8, frente a 12,7 de EchoWM, el único otro modelo de mundo de la comparación que genera sonido. El artículo está en arXiv, el código en GitHub, un checkpoint de vista previa en Hugging Face y la demo interactiva en helixworld.org.
Por qué los modelos de mundo necesitan sonido
Los modelos de mundo interactivos permiten dirigir un entorno generado en tiempo real, pero la mayoría son mudos. Y el sonido transmite información que la imagen no da: de qué material es una superficie, con qué fuerza chocan dos objetos y qué ocurre fuera de plano. En una escena inmersiva, girar la cabeza también debería mover el sonido entre el oído izquierdo y el derecho.
Añadir el audio a posteriori no lo resuelve. Un modelo de vídeo a audio (V2A) en cascada nunca ve la trayectoria de la cámara ni las acciones del usuario, así que su sonido ignora el movimiento propio, y ejecutarlo después del vídeo añade latencia. Los modelos fundacionales audiovisuales bidireccionales generan ambas señales, pero no tienen interfaz de control, y convertirlos sin más en modelos causales de streaming hace que los errores se acumulen hasta degradar imagen y sonido. Helix World aborda los tres problemas: falta de datos de entrenamiento, falta de control y deriva en secuencias largas.
Explora mundos en tiempo real
En la demo eliges una imagen inicial o subes la tuya; se codifica a 768×512. El prompt de texto es opcional: si lo dejas vacío, la escena se describe automáticamente a partir del fotograma. Una vez iniciada la sesión, WASD mueve la cámara y las flechas cambian la vista. La generación avanza en bloques de unos 1,3 segundos, y cada tecla o prompt nuevo se aplica desde el bloque siguiente, así que puedes cambiar el rumbo de la escena mientras se ejecuta.
Benchmarks
Calidad visual y velocidad
Medimos la calidad visual y el seguimiento de acciones en la partición de navegación de WBench. El factor de tiempo real son los segundos de cómputo necesarios por segundo de vídeo generado, medidos en una NVIDIA H800 incluyendo la decodificación de vídeo y audio; por debajo de 1,0 es más rápido que el tiempo real. Tabla 3 del artículo:
Modelo | Audio nativo | RTF (H800) ↓ | Media WBench ↑ |
|---|---|---|---|
Alaya-EVOKE-Turbo | No | 4,29 | 82,0 |
EchoWM | Sí | 1,98 | 81,0 |
Zing-0.5 | No | 2,81 | 81,0 |
Helix World | Sí | 0,77 | 79,9 |
LingBot-World v2 | No | 5,21 | 79,4 |
SANA-WM | No | 0,79 | 76,0 |
LTX-2.3 (base) | Sí | 14,61 | 74,2 |
Matrix-Game 3 | No | 0,58 | 71,3 |
Entre los modelos más rápidos que el tiempo real, Helix World tiene la puntuación más alta: 79,9, frente a 76,0 de SANA-WM y 71,3 de Matrix-Game 3. Los tres modelos por encima necesitan entre 1,98 y 4,29 segundos de cómputo por segundo de vídeo, y dos de ellos no generan sonido. Helix World es el único modelo en tiempo real de la tabla que también genera audio.
Sonido que sigue a la cámara
Los benchmarks de modelos de mundo existentes solo evalúan vídeo, y los audiovisuales usan clips cortos sin movimiento de cámara. HelixBench cubre ese hueco con 1.015 casos verificados por personas en seis dominios y cuatro subconjuntos: navegación, perspectiva, evento y sujeto. Cada caso incluye un fotograma inicial, un prompt audiovisual, poses de cámara continuas y una referencia estéreo. Su puntuación espacial correlaciona la posición en pantalla de las fuentes sonoras con el panorama estéreo izquierda-derecha, de modo que mide directamente si el campo sonoro gira con la cámara.
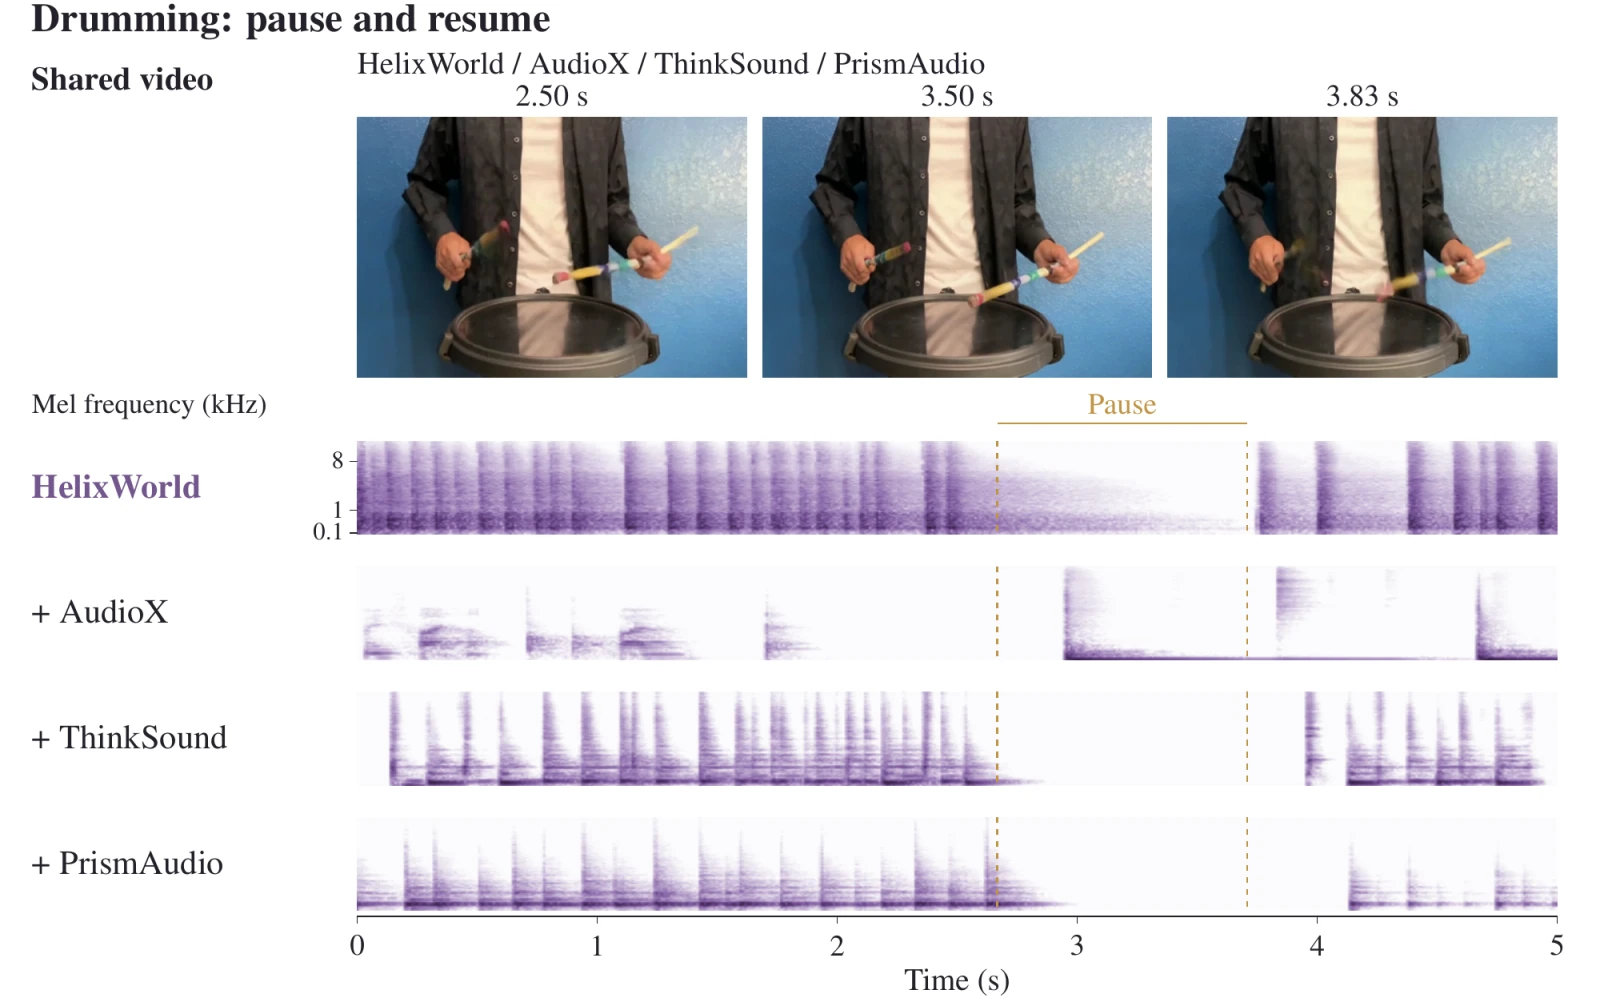
Las referencias incluyen EchoWM y cadenas en cascada en las que silenciamos el vídeo de Helix World y lo redoblamos con un modelo V2A (AudioX, ThinkSound, PrismAudio): la imagen queda fija y solo cambia el audio. Tabla 4 del artículo:
Modelo | KL ↓ | FAD ↓ | DeSync (s) ↓ | ImageBind ↑ | CLAP ↑ | Espacial ↑ |
|---|---|---|---|---|---|---|
Helix World (estudiante causal) | 1,39 | 2,39 | 0,59 | 0,299 | 0,302 | 41,8 |
Helix World (profesor bidireccional) | 1,54 | 3,08 | 0,50 | 0,270 | 0,268 | 33,2 |
EchoWM | 1,95 | 7,75 | 0,67 | 0,204 | 0,235 | 12,6 |
Helix World + ThinkSound | 2,23 | 6,19 | 0,42 | 0,208 | 0,289 | 14,8 |
Helix World + AudioX | 2,02 | 3,92 | 1,18 | 0,257 | 0,309 | −5,7 |
Helix World + PrismAudio | 2,24 | 6,39 | 0,46 | 0,215 | 0,272 | −9,5 |
LTX-2.3 (base) | 1,80 | 7,64 | 0,40 | 0,278 | 0,258 | 1,0 |
Helix World lidera en fidelidad de audio (KL, FAD), alineación semántica audiovisual (ImageBind) y coherencia espacial. No gana en todo: LTX-2.3 y la cadena con ThinkSound tienen menor desfase temporal (DeSync), y la cadena con AudioX puntúa algo más en alineación texto-audio (CLAP). Las cadenas de redoblaje obtienen puntuaciones espaciales negativas porque un modelo V2A no sabe dónde están las fuentes sonoras respecto a la cámara.
Qué prefirieron las personas
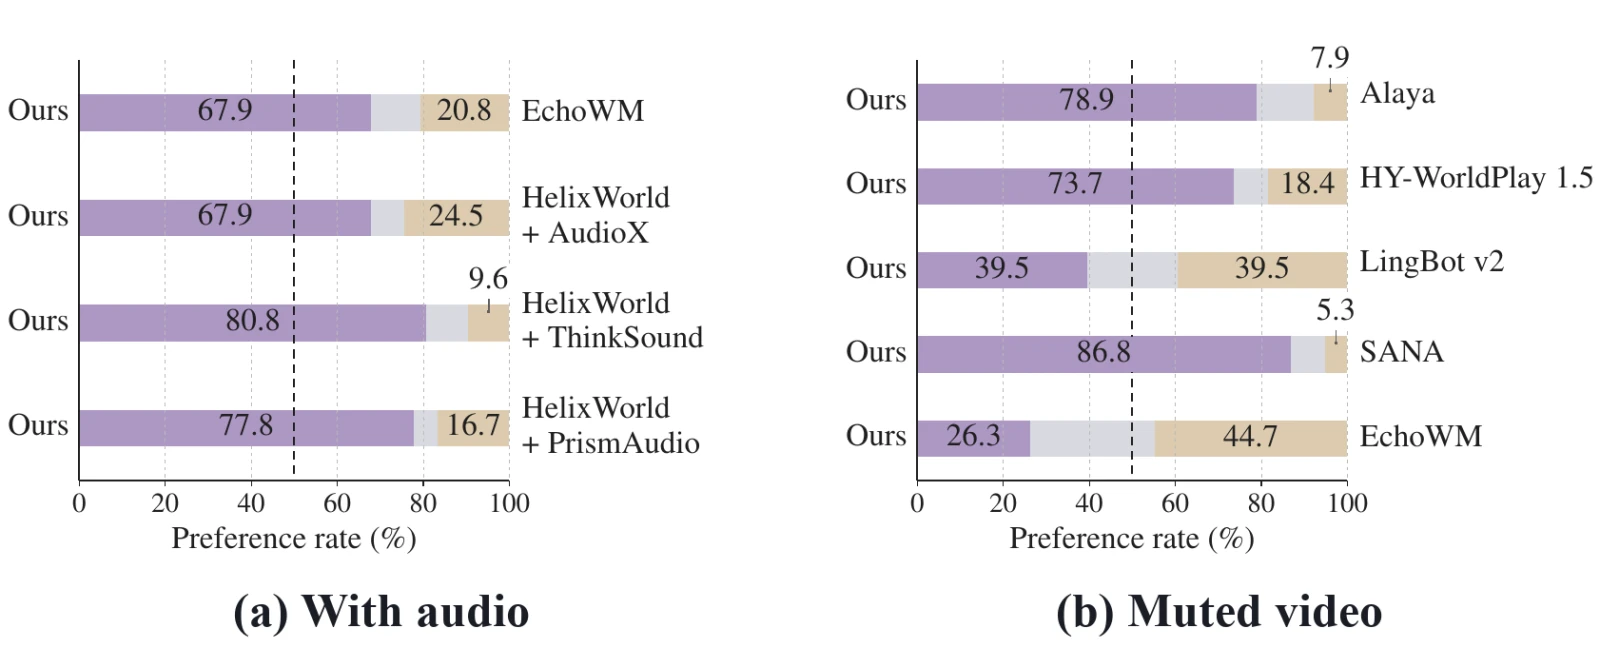
En un estudio con usuarios sobre secuencias audiovisuales completas, los participantes prefirieron Helix World frente a EchoWM por 67,9 % a 20,8 %, y frente a las versiones redobladas de su propio vídeo por 67,9 % a 24,5 % (AudioX), 80,8 % a 9,6 % (ThinkSound) y 77,8 % a 16,7 % (PrismAudio); el resto fueron empates. Sin sonido, Helix World fue preferido frente a SANA-WM, Alaya y HY-WorldPlay 1.5, empató con LingBot-World v2 (39,5 % cada uno) y quedó por detrás de EchoWM, 26,3 % a 44,7 %. Su ventaja viene sobre todo del audio.
Cómo construimos Helix World
Datos: estéreo real con poses de cámara métricas
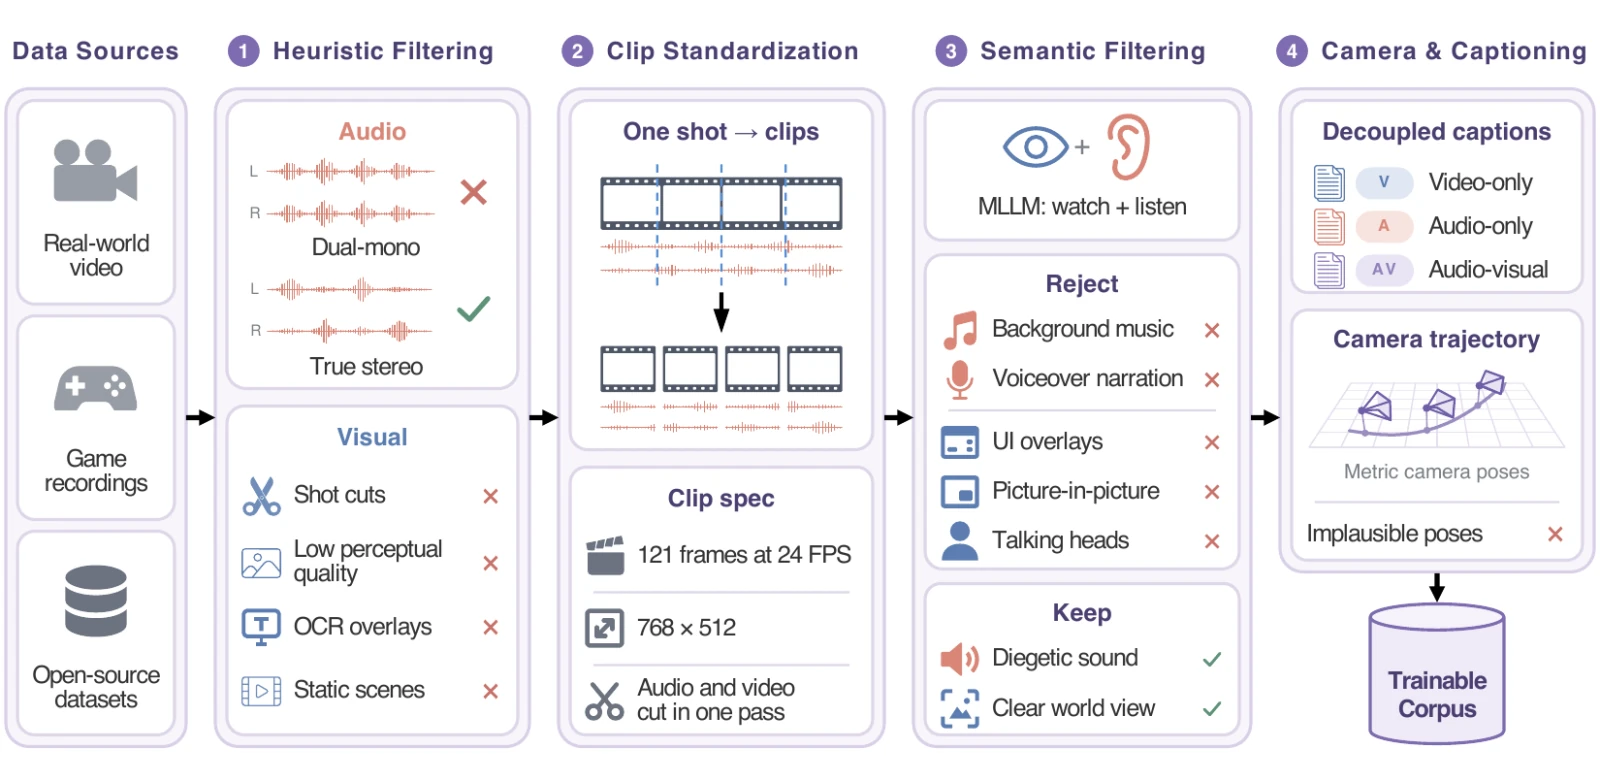
La mayoría de los corpus de vídeo no sirven para esta tarea: el audio suele ser música de fondo, locución o falso estéreo con canales idénticos. Partimos de 4.100 horas de material bruto (43,9 % vídeo del mundo real, 34,1 % grabaciones de videojuegos, 22,0 % conjuntos de datos abiertos) y lo filtramos en cuatro etapas, de la más barata a la más costosa:
Filtrado heurístico: elimina audio mono duplicado, cortes de plano, baja calidad perceptual, textos superpuestos y escenas estáticas.
Estandarización de clips: corta audio y vídeo a la vez en clips de 121 fotogramas a 24 fps y 768×512, con estéreo a 48 kHz.
Filtrado semántico: un LLM multimodal que ve y escucha descarta música de fondo, narración, superposiciones de interfaz, imagen en imagen y bustos parlantes, y conserva el sonido diegético.
Cámara y descripciones: recupera poses de cámara métricas por fotograma y escribe tres pistas de descripción: solo vídeo, solo audio y audiovisual.
El resultado son 3.000 horas en 2,1 millones de clips, un rendimiento del 73,1 %. En una ablación, entrenar con las tres pistas de descripción dio la mejor alineación audiovisual.
Un profesor bidireccional con control de cámara y acciones
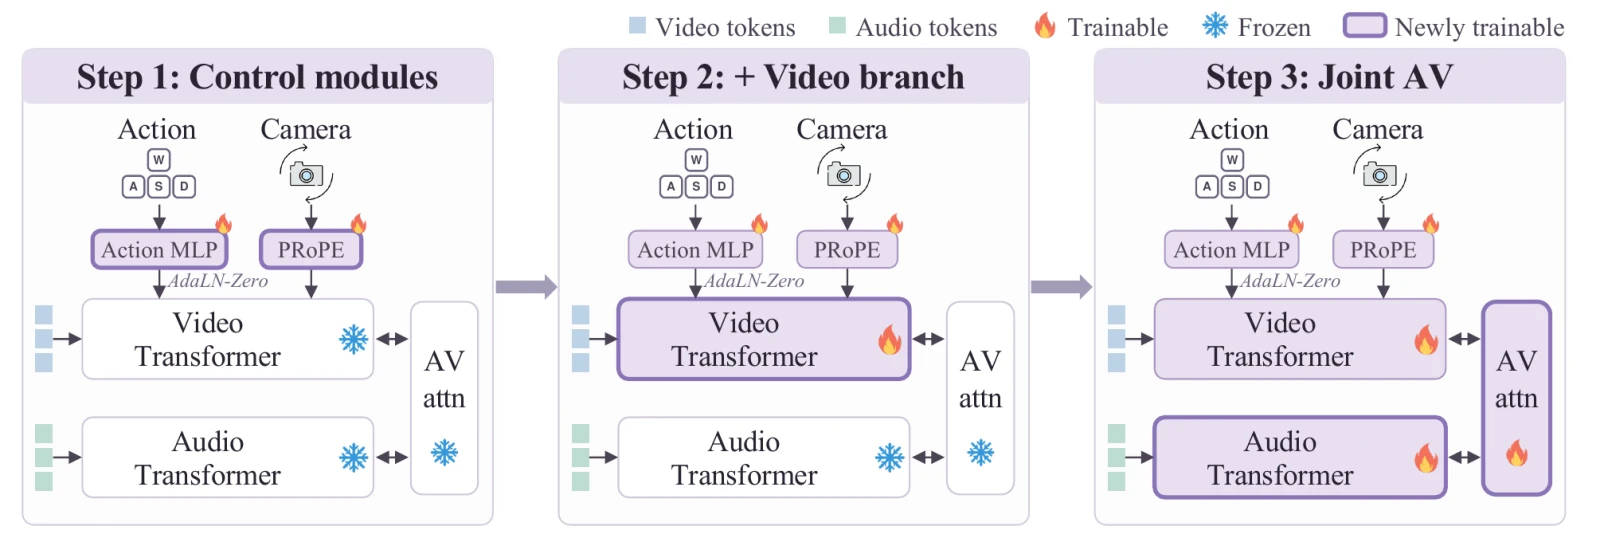
Helix World parte del modelo audiovisual de código abierto LTX-2.3. Las trayectorias de cámara continuas de 6 grados de libertad entran en la atención visual mediante PRoPE, y las acciones discretas de teclado mediante AdaLN-Zero sobre el paso temporal de difusión. La atención cruzada entre modalidades une la geometría visual con los rasgos de audio, y así el movimiento de cámara se convierte en panorama estéreo.
El entrenamiento es progresivo: primero los módulos de control, después la rama de vídeo y por último todo el núcleo audiovisual. Frente a ajustar todo a la vez, reduce el error de rotación de cámara de 0,1237 a 0,1144 y el de traslación de 0,0957 a 0,0823, y conserva la calidad visual preentrenada.
Un estudiante causal que transmite sin deriva
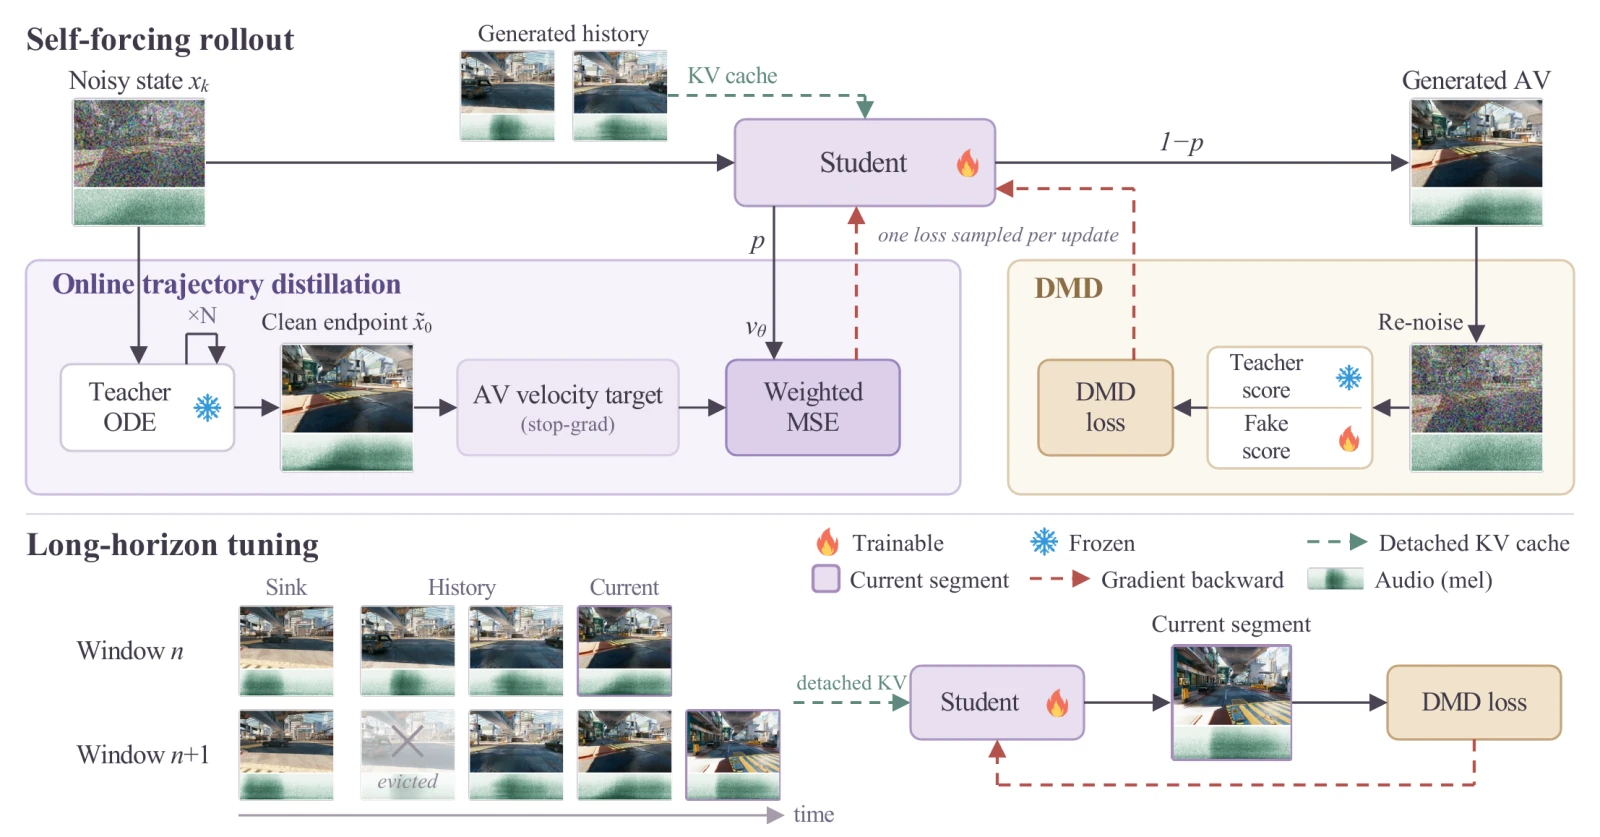
El profesor bidireccional ve el clip entero, así que no puede responder a la entrada en directo. Lo destilamos en un estudiante causal de pocos pasos que genera bloque a bloque con una caché clave-valor deslizante y fotogramas sink fijos. El estudiante se inicializa por regresión sobre las salidas ODE del profesor y después se entrena con self-forcing sobre sus propias secuencias.
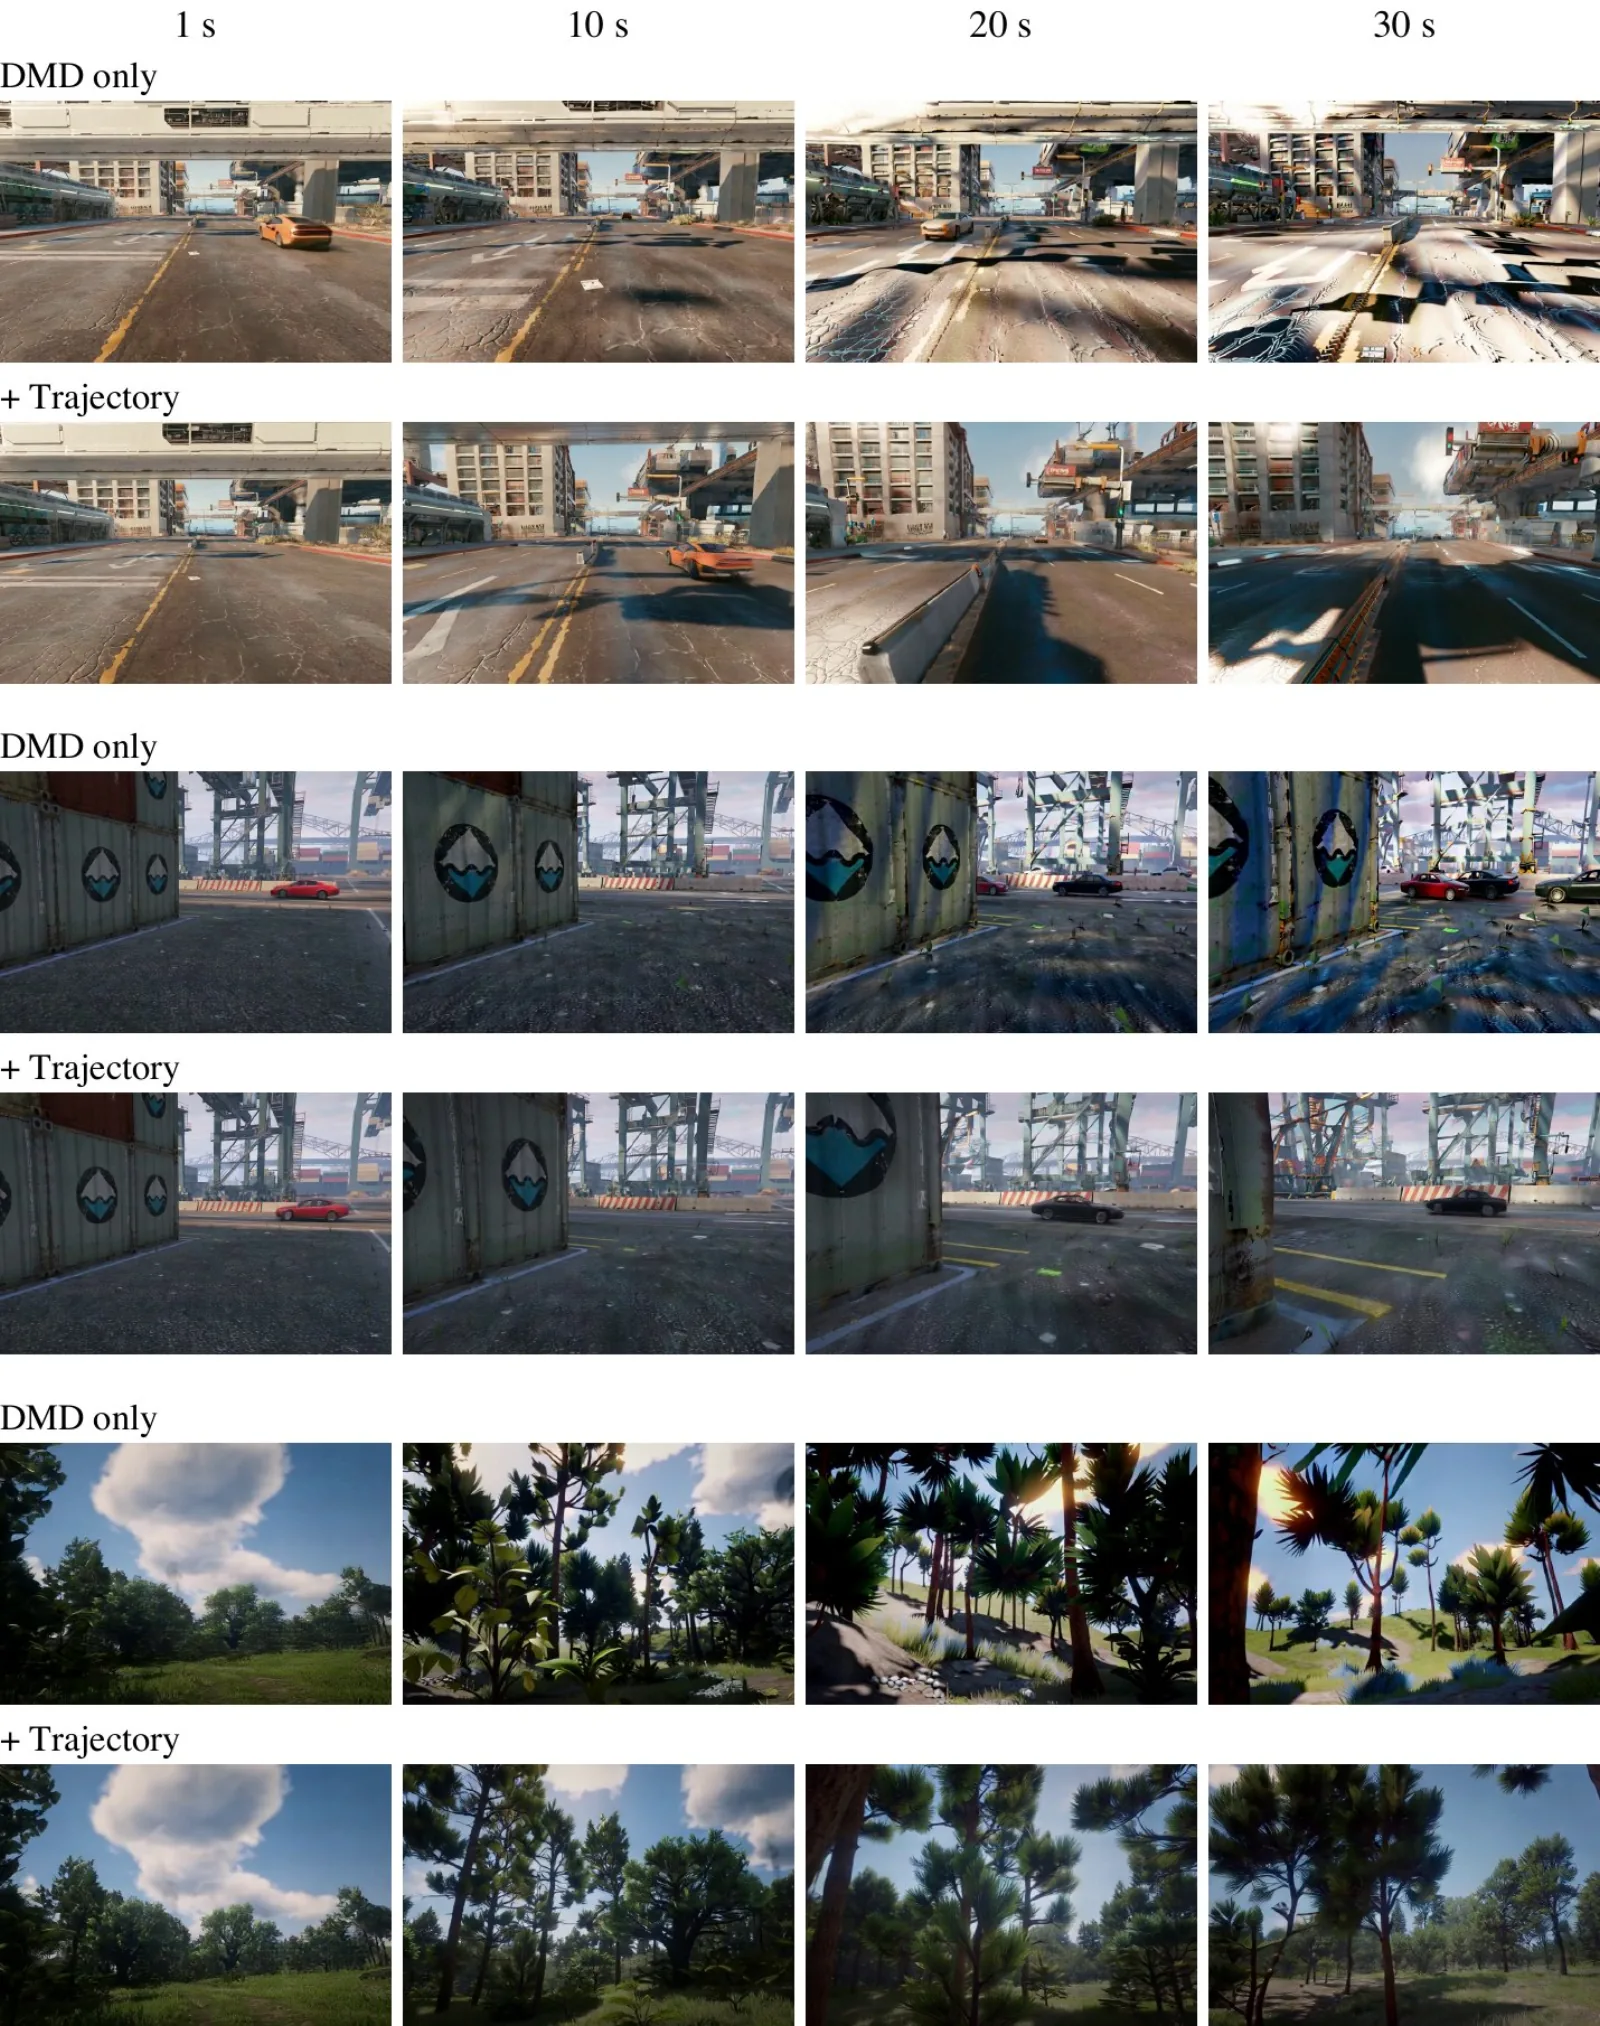
El self-forcing solo con destilación por emparejamiento de distribuciones (DMD) sigue derivando en secuencias largas. Nuestra aportación es una pérdida de destilación de trayectoria en línea: en cada actualización, con probabilidad p, la velocidad del estudiante en un estado intermedio se supervisa con el objetivo ODE de flujo de probabilidad del profesor; si no, se usa la pérdida DMD. Una etapa final de streaming de horizonte largo entrena con ventanas extendidas. En conjunto elevan la puntuación WBench de 77,9 a 79,1 y mantienen estables las secuencias de 30 segundos.
Limitaciones
La resolución de salida es 768×512. La velocidad en tiempo real se mide en una GPU de centro de datos NVIDIA H800; el artículo no da cifras para GPU de consumo.
El checkpoint público es una versión de vista previa.
Solo en calidad visual, Helix World queda algo por detrás de los mejores modelos sin sonido (79,9 frente a 82,0 de media WBench), y con el sonido silenciado los participantes prefirieron EchoWM.
Helix World no tiene el DeSync más bajo en HelixBench, así que la precisión en los ataques del sonido aún puede mejorar.
Para otro enfoque del mismo problema, añadir estéreo en streaming a un modelo de mundo existente, consulta nuestro artículo sobre WorldSonus.
Prueba Helix World
La demo interactiva está abierta en helixworld.org. El artículo completo, "HelixWorld: A Real-time Interactive Audio-Visual World Model" (arXiv:2609.38123, 29 de septiembre de 2026), está en arXiv. El código está en GitHub y los pesos de vista previa en Hugging Face.
Autores: Lei Ke, Jiahao Pan y Zeyue Tian (contribución igual), Jiaming Wang, Haoyuan Huang, Kam Man Wu, Pengjun Fang, Hongyu Liu, Chenyang Qi, Lin Wang, Ruibin Yuan, Weijia Chen, Fangneng Zhan, Qifeng Chen, Wei Xue y Yike Guo. Autores de correspondencia: Zeyue Tian y Wei Xue. Universidad de Ciencia y Tecnología de Hong Kong y Noiz AI.