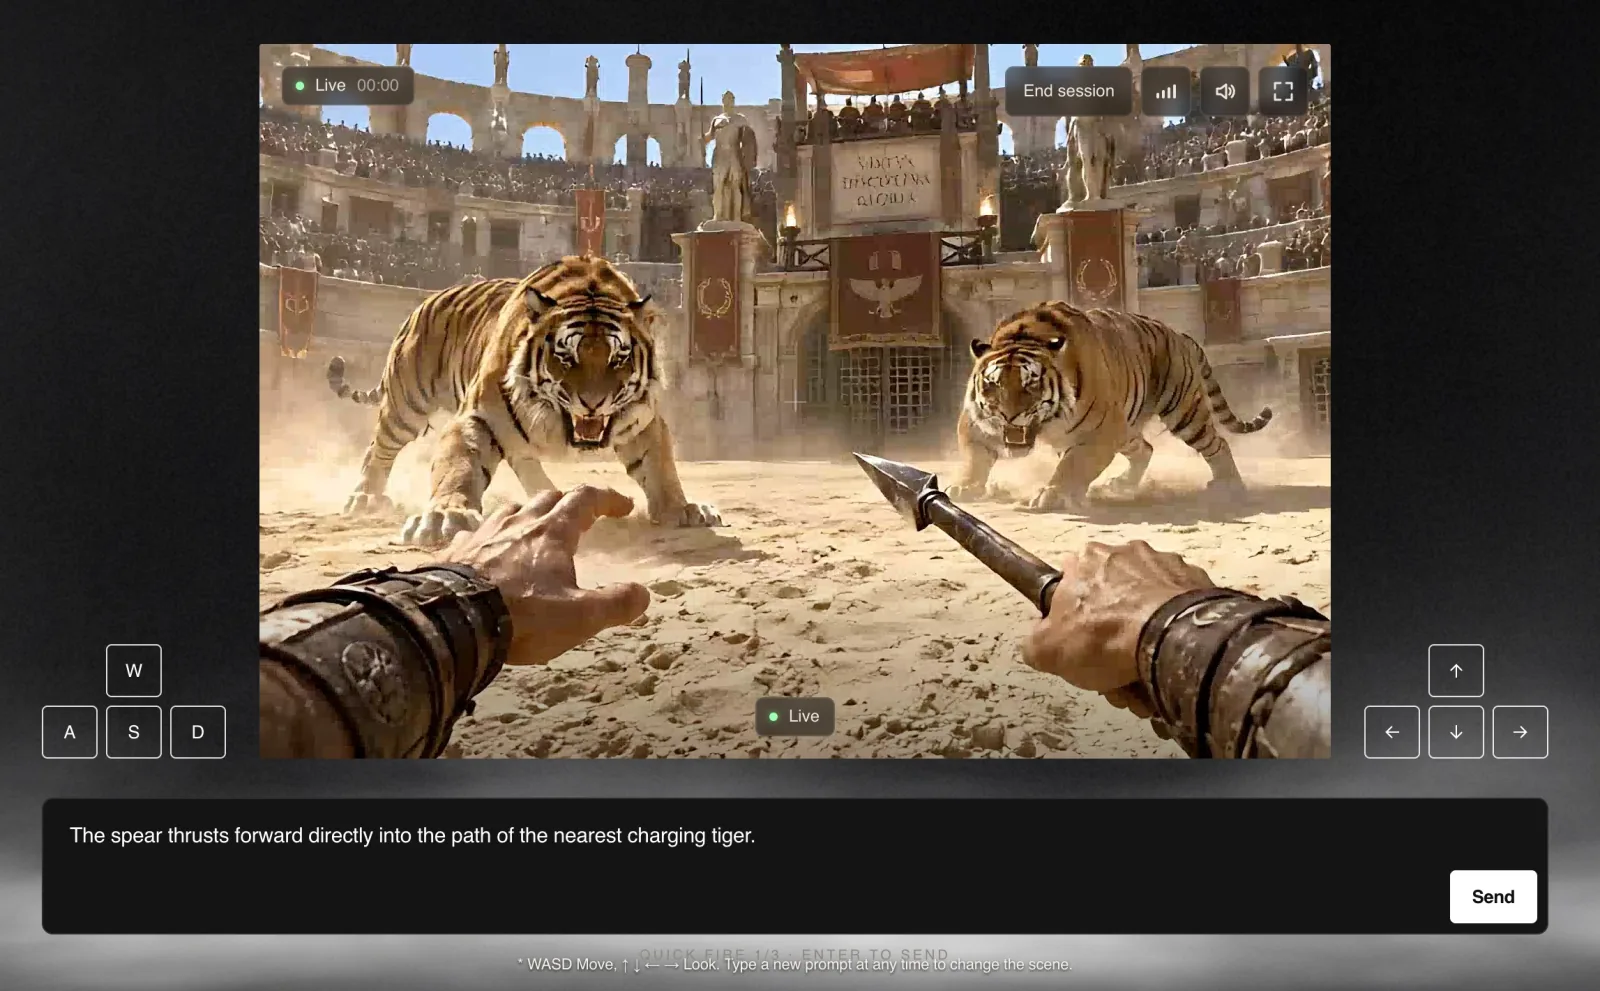
今天我们发布 Helix World。这是 Noiz AI 与香港科技大学(HKUST)联合研发的实时交互式音画世界模型。从一张图片出发,用 WASD 移动、方向键环顾,模型会同时生成接下来的画面和对应的立体声,在单张 NVIDIA H800 GPU 上达到每秒 24 帧。
Helix World 是一个世界模型:它根据用户的镜头运动和键盘操作,同时生成可探索的场景和与之匹配的空间立体声。镜头转向时,声场也跟着转。
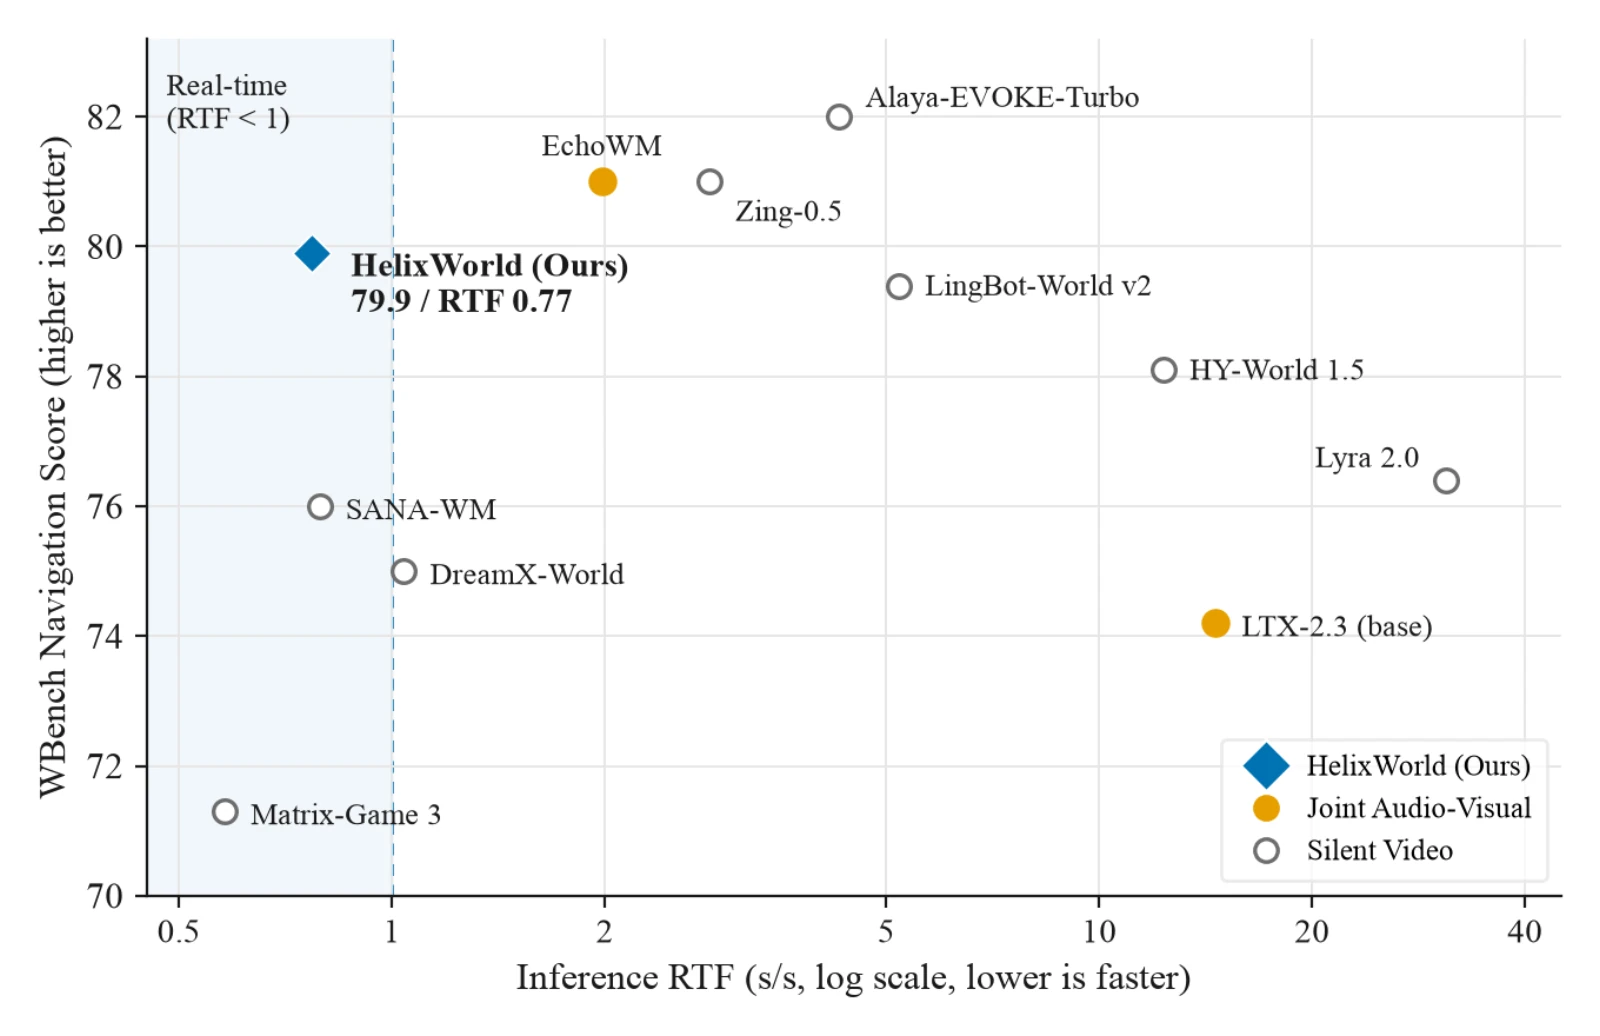
在 WBench 导航子集上,Helix World 得分 79.9,接近最强的无声世界模型,同时快于实时,实时率(RTF)为 0.77。在我们随模型发布的音画基准 HelixBench 上,它的空间声学一致性得分为 41.8;对比中唯一能出声音的世界模型 EchoWM 为 12.7。论文已上线 arXiv,代码在 GitHub,预览版权重在 Hugging Face,交互式 demo 可在 helixworld.org 试用。
世界模型为什么需要声音
交互式世界模型让用户实时操控生成的环境,但大多数是无声的。声音承载着画面给不了的信息:表面是什么材质、两个物体撞得多重、画面外正在发生什么。在沉浸式场景里,转头时声音也应该在左右耳之间移动。
事后补配音解决不了这个问题。级联的视频转音频(V2A)模型看不到镜头轨迹和用户操作,声音不会随视角变化,而且排在视频之后会增加延迟。双向音画基础模型能同时生成两路信号,但没有控制接口;直接改成因果流式生成,误差会不断累积,画面和声音一起崩坏。Helix World 同时解决了三个问题:缺训练数据、缺控制、长时生成漂移。
实时探索生成的世界
在 demo 里,你可以选一张起始图片或上传自己的图片,图片会编码为 768×512。文字提示可选:留空时,系统会根据画面自动描述场景。会话开始后,WASD 移动镜头,方向键改变视角。生成按约 1.3 秒一段进行,每次按键或新提示从下一段开始生效,所以运行中也能改变场景走向。
基准结果
画面质量与速度
我们在 WBench 导航子集上评估画面质量和动作跟随。实时率指每生成 1 秒视频所需的计算秒数,在单张 NVIDIA H800 上测量,包含视频和音频解码;低于 1.0 即快于实时。论文表 3:
模型 | 原生音频 | RTF(H800)↓ | WBench 均分 ↑ |
|---|---|---|---|
Alaya-EVOKE-Turbo | 否 | 4.29 | 82.0 |
EchoWM | 是 | 1.98 | 81.0 |
Zing-0.5 | 否 | 2.81 | 81.0 |
Helix World | 是 | 0.77 | 79.9 |
LingBot-World v2 | 否 | 5.21 | 79.4 |
SANA-WM | 否 | 0.79 | 76.0 |
LTX-2.3(基座) | 是 | 14.61 | 74.2 |
Matrix-Game 3 | 否 | 0.58 | 71.3 |
在快于实时的模型中,Helix World 得分最高:79.9,SANA-WM 为 76.0,Matrix-Game 3 为 71.3。排在它前面的三个模型每秒视频需要 1.98 到 4.29 秒计算,其中两个没有声音。表中只有 Helix World 既实时又能生成声音。
声音跟着镜头走
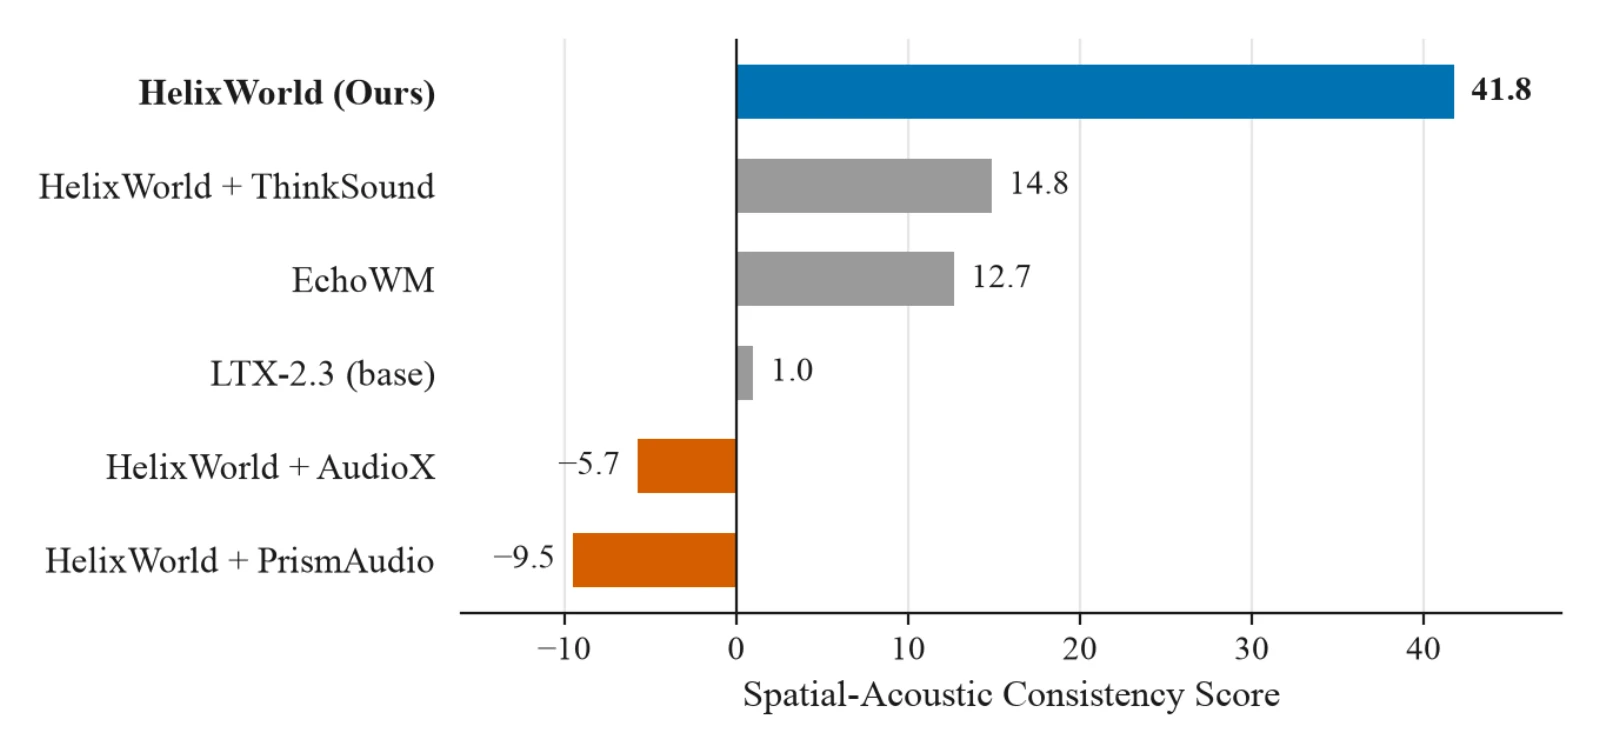
现有世界模型基准只评估视频,音画基准又只用没有镜头运动的短片。HelixBench 填补了这个空白:1,015 个人工核验的案例,覆盖 6 个领域和 4 个子集(导航、视角、事件、主体)。每个案例包含起始帧、音画提示、连续镜头位姿和立体声参考。空间得分把画面上声源的位置与左右声道的声像做相关,直接衡量声场是否随镜头转动。
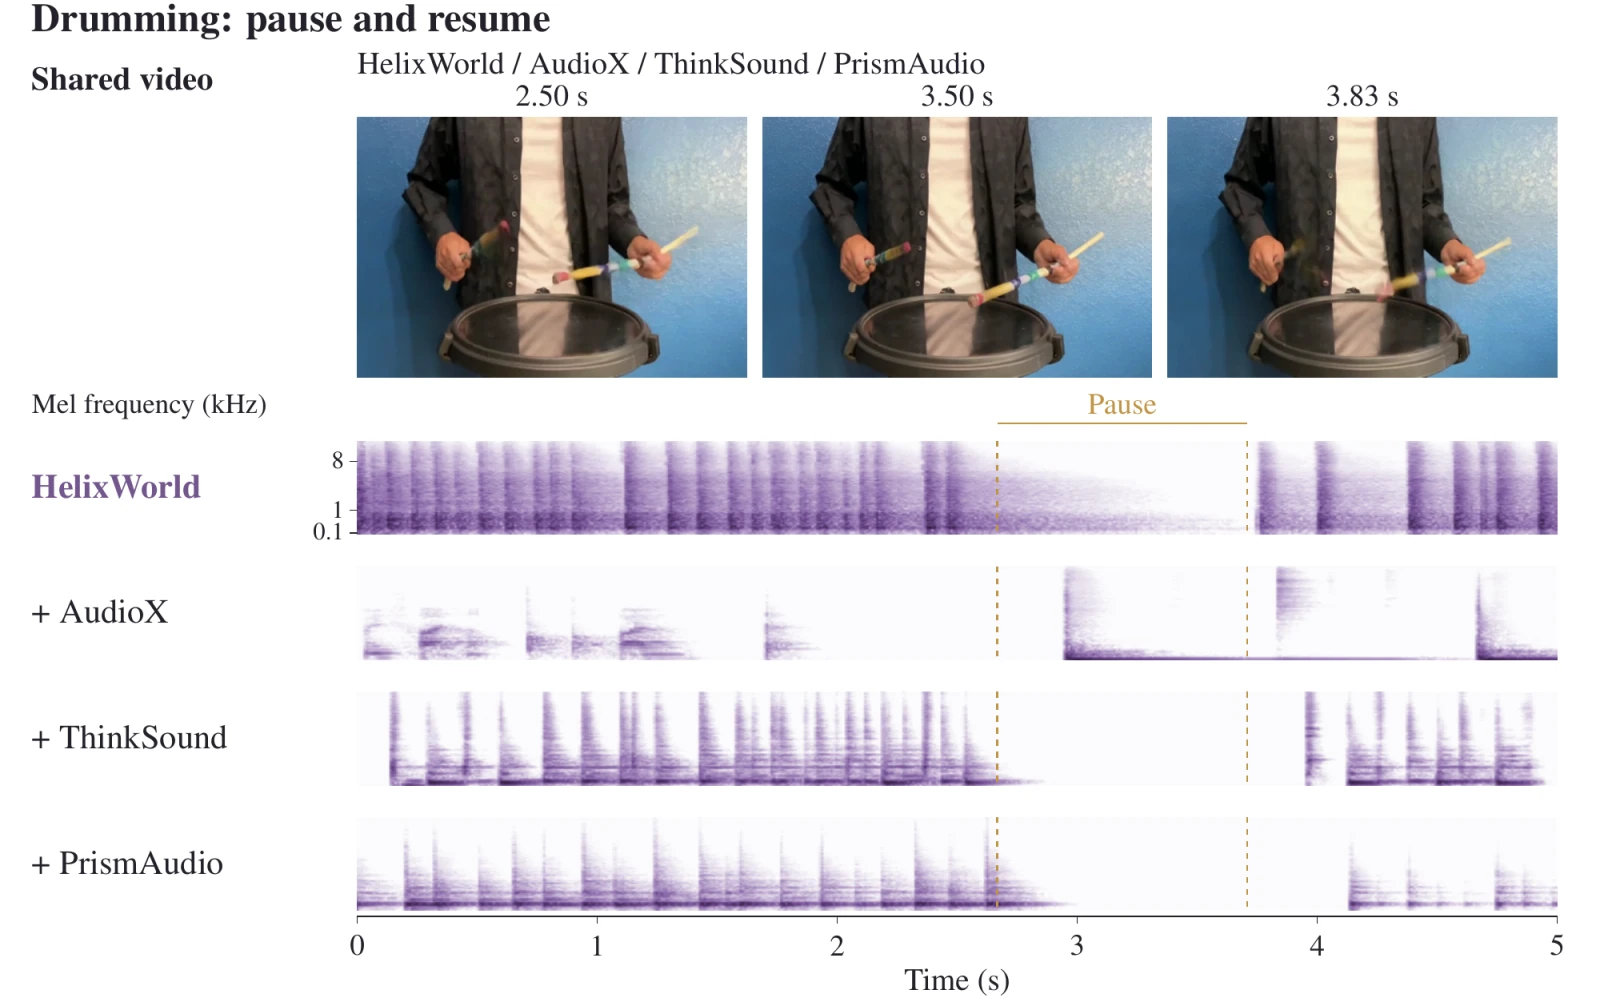
对比对象包括 EchoWM,以及级联方案:把 Helix World 的视频静音后,用 V2A 模型(AudioX、ThinkSound、PrismAudio)重新配音,画面不变,只比较音频。论文表 4:
模型 | KL ↓ | FAD ↓ | DeSync(秒)↓ | ImageBind ↑ | CLAP ↑ | 空间 ↑ |
|---|---|---|---|---|---|---|
Helix World(因果学生) | 1.39 | 2.39 | 0.59 | 0.299 | 0.302 | 41.8 |
Helix World(双向教师) | 1.54 | 3.08 | 0.50 | 0.270 | 0.268 | 33.2 |
EchoWM | 1.95 | 7.75 | 0.67 | 0.204 | 0.235 | 12.6 |
Helix World + ThinkSound | 2.23 | 6.19 | 0.42 | 0.208 | 0.289 | 14.8 |
Helix World + AudioX | 2.02 | 3.92 | 1.18 | 0.257 | 0.309 | −5.7 |
Helix World + PrismAudio | 2.24 | 6.39 | 0.46 | 0.215 | 0.272 | −9.5 |
LTX-2.3(基座) | 1.80 | 7.64 | 0.40 | 0.278 | 0.258 | 1.0 |
Helix World 在音频保真度(KL、FAD)、音画语义对齐(ImageBind)和空间一致性上领先,但并非全面第一:LTX-2.3 和 ThinkSound 方案的时间偏移(DeSync)更低,AudioX 方案的文本-音频对齐(CLAP)略高。重配音方案的空间得分为负,因为 V2A 模型不知道声源相对镜头的位置。
用户更喜欢哪个
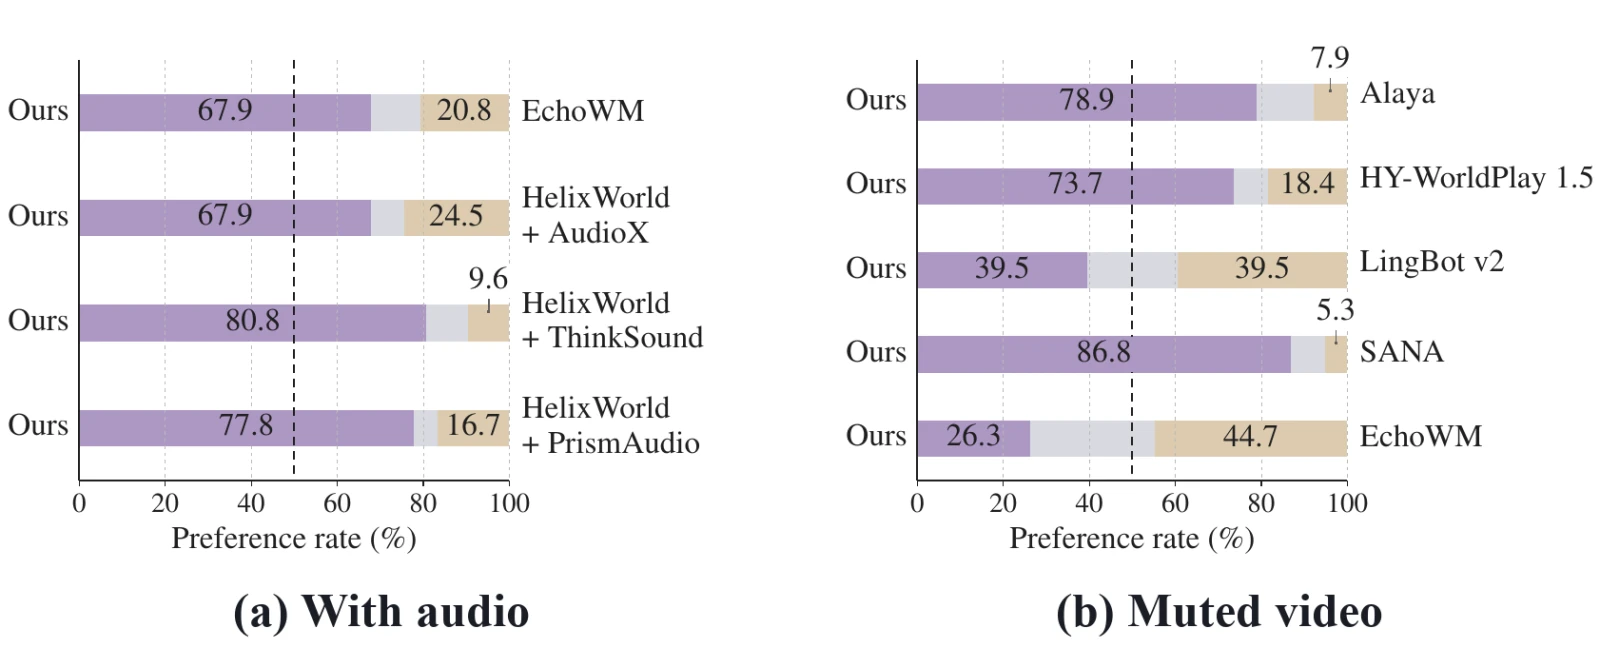
在完整音画片段的用户研究中,参与者更偏好 Helix World:对 EchoWM 为 67.9% 比 20.8%;对用同一视频重配音的版本分别为 67.9% 比 24.5%(AudioX)、80.8% 比 9.6%(ThinkSound)、77.8% 比 16.7%(PrismAudio),其余为平局。静音观看时,Helix World 优于 SANA-WM、Alaya 和 HY-WorldPlay 1.5,与 LingBot-World v2 打平(各 39.5%),但不如 EchoWM(26.3% 比 44.7%)。它的优势主要来自声音。
Helix World 是怎么做出来的
数据:真立体声加度量级镜头位姿
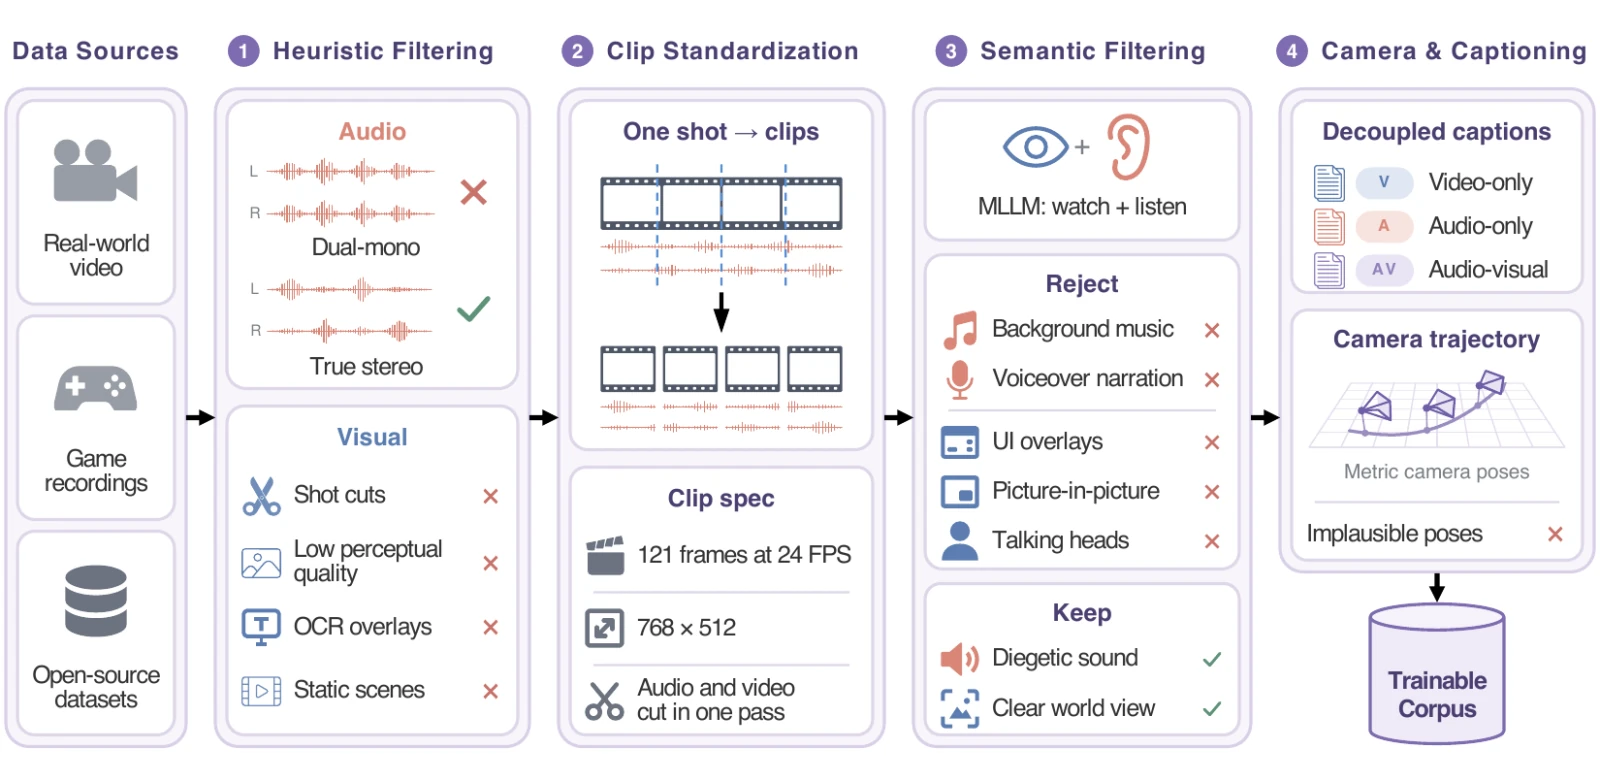
大多数视频语料不适合这个任务:音轨常是背景音乐、旁白,或左右声道相同的伪立体声。我们从 4,100 小时原始素材出发(真实世界视频 43.9%、游戏录屏 34.1%、开源数据集 22.0%),按计算成本从低到高分四步过滤:
启发式过滤:剔除双单声道音频、镜头切换、低画质、文字叠加和静态画面。
片段标准化:音视频一次切成 121 帧、24 fps、768×512 的片段,配 48 kHz 立体声。
语义过滤:多模态大模型同时看画面、听声音,剔除背景音乐、旁白、UI 叠加、画中画和口播,保留场景内的真实声音。
镜头与描述:为每一帧恢复度量级镜头位姿,并写三轨描述:仅画面、仅声音、音画结合。
最终得到 3,000 小时、210 万个片段,保留率 73.1%。消融实验显示,三轨描述带来最好的音画对齐。
带镜头和动作控制的双向教师模型
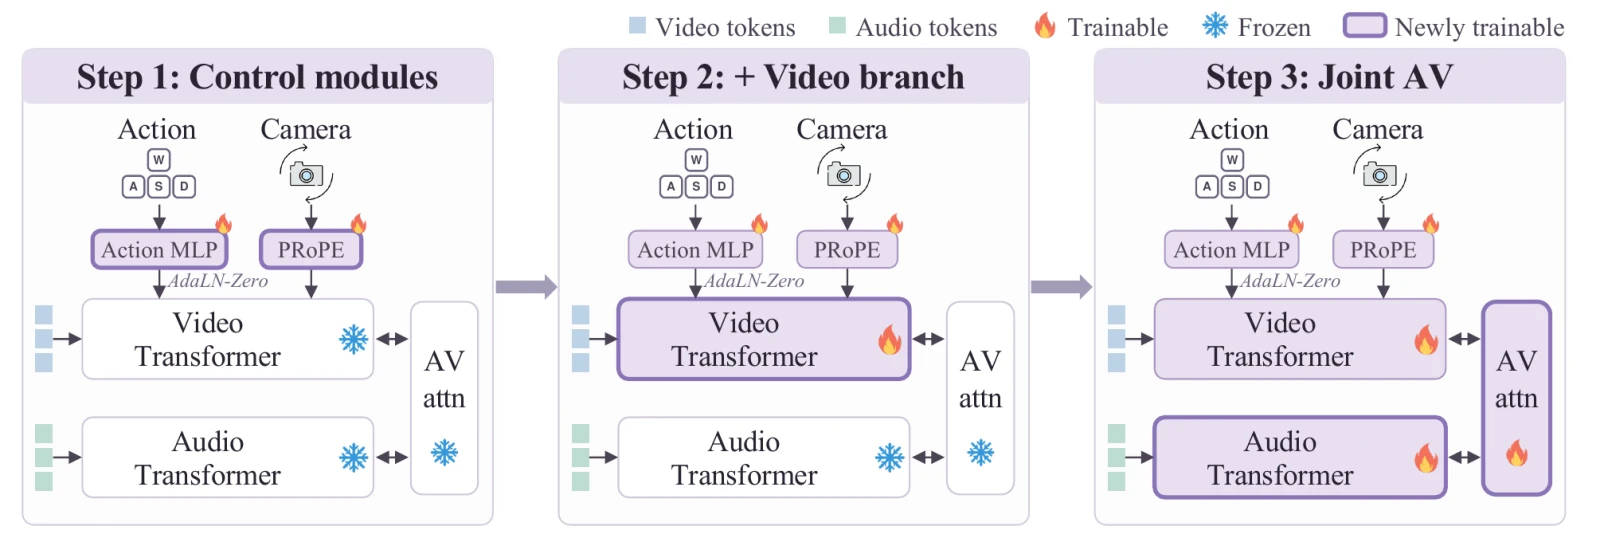
Helix World 基于开源音画模型 LTX-2.3。连续的 6 自由度镜头轨迹通过 PRoPE 注入视觉注意力,离散键盘动作通过扩散时间步上的 AdaLN-Zero 注入。跨模态注意力再把视觉几何绑定到音频特征上,镜头运动由此变成立体声声像的移动。
训练是渐进式的:先训控制模块,再训视频分支,最后训完整的音画主干。与一次性全量微调相比,镜头旋转误差从 0.1237 降到 0.1144,平移误差从 0.0957 降到 0.0823,同时保住了预训练的画面质量。
不漂移的因果学生模型
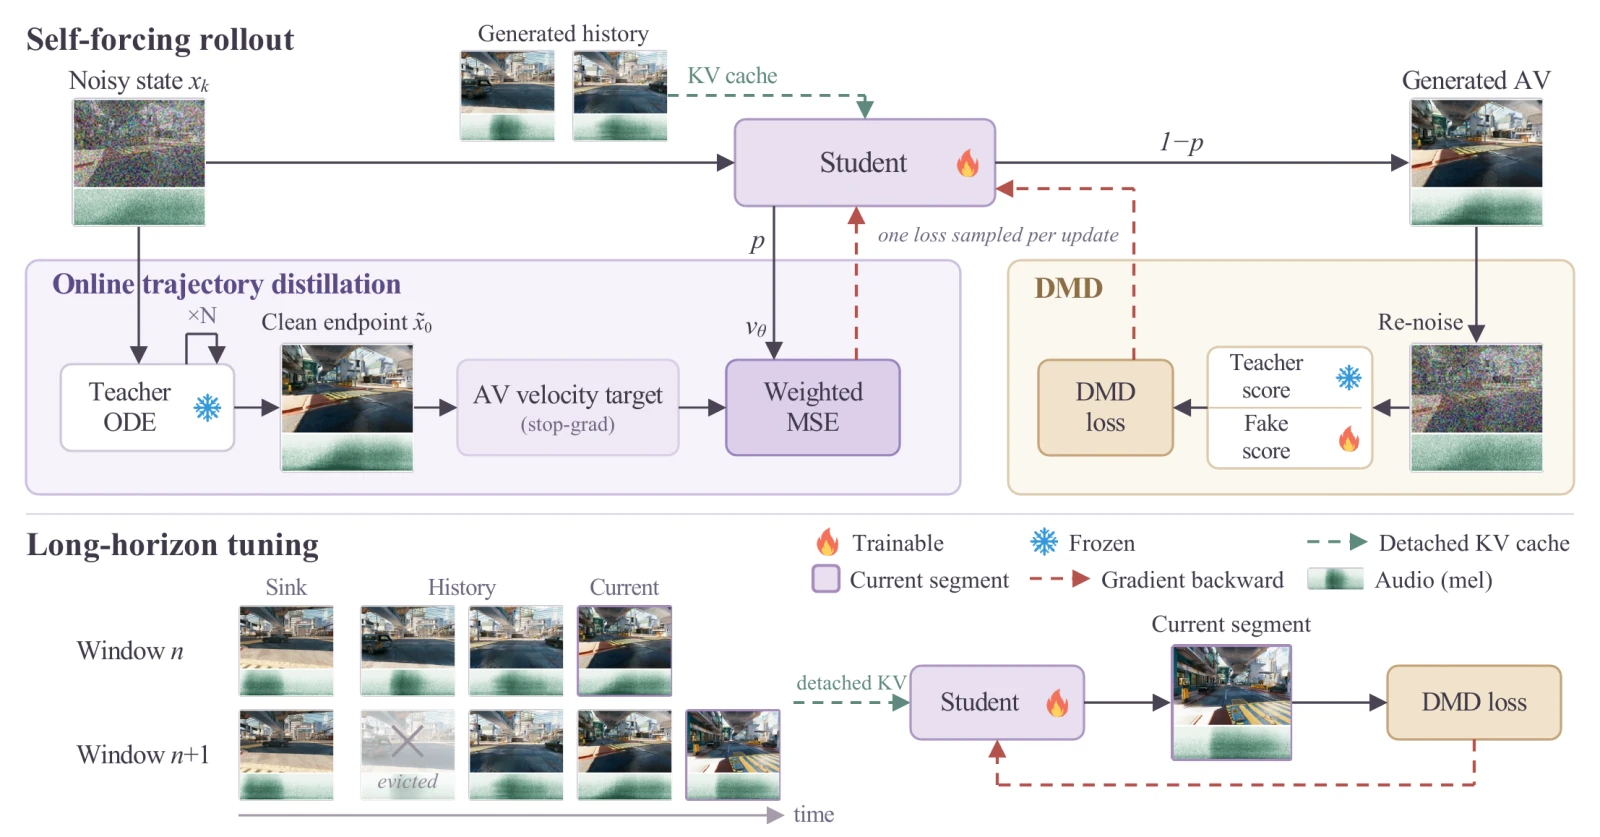
双向教师模型一次看完整段,无法响应实时输入。我们把它蒸馏成少步数的因果学生模型:按块生成,使用滑动 KV 缓存和固定的 sink 帧。学生先回归教师的 ODE 输出做初始化,再在自己的生成结果上做 self-forcing 训练。
只用分布匹配蒸馏(DMD)的 self-forcing 在长时生成中仍会漂移。我们加入了在线轨迹蒸馏损失:每次更新以概率 p 用教师的概率流 ODE 目标监督学生在中间状态的速度,否则使用 DMD 损失。最后再做一轮长时流式训练。两者合起来把 WBench 得分从 77.9 提到 79.1,30 秒生成保持稳定。
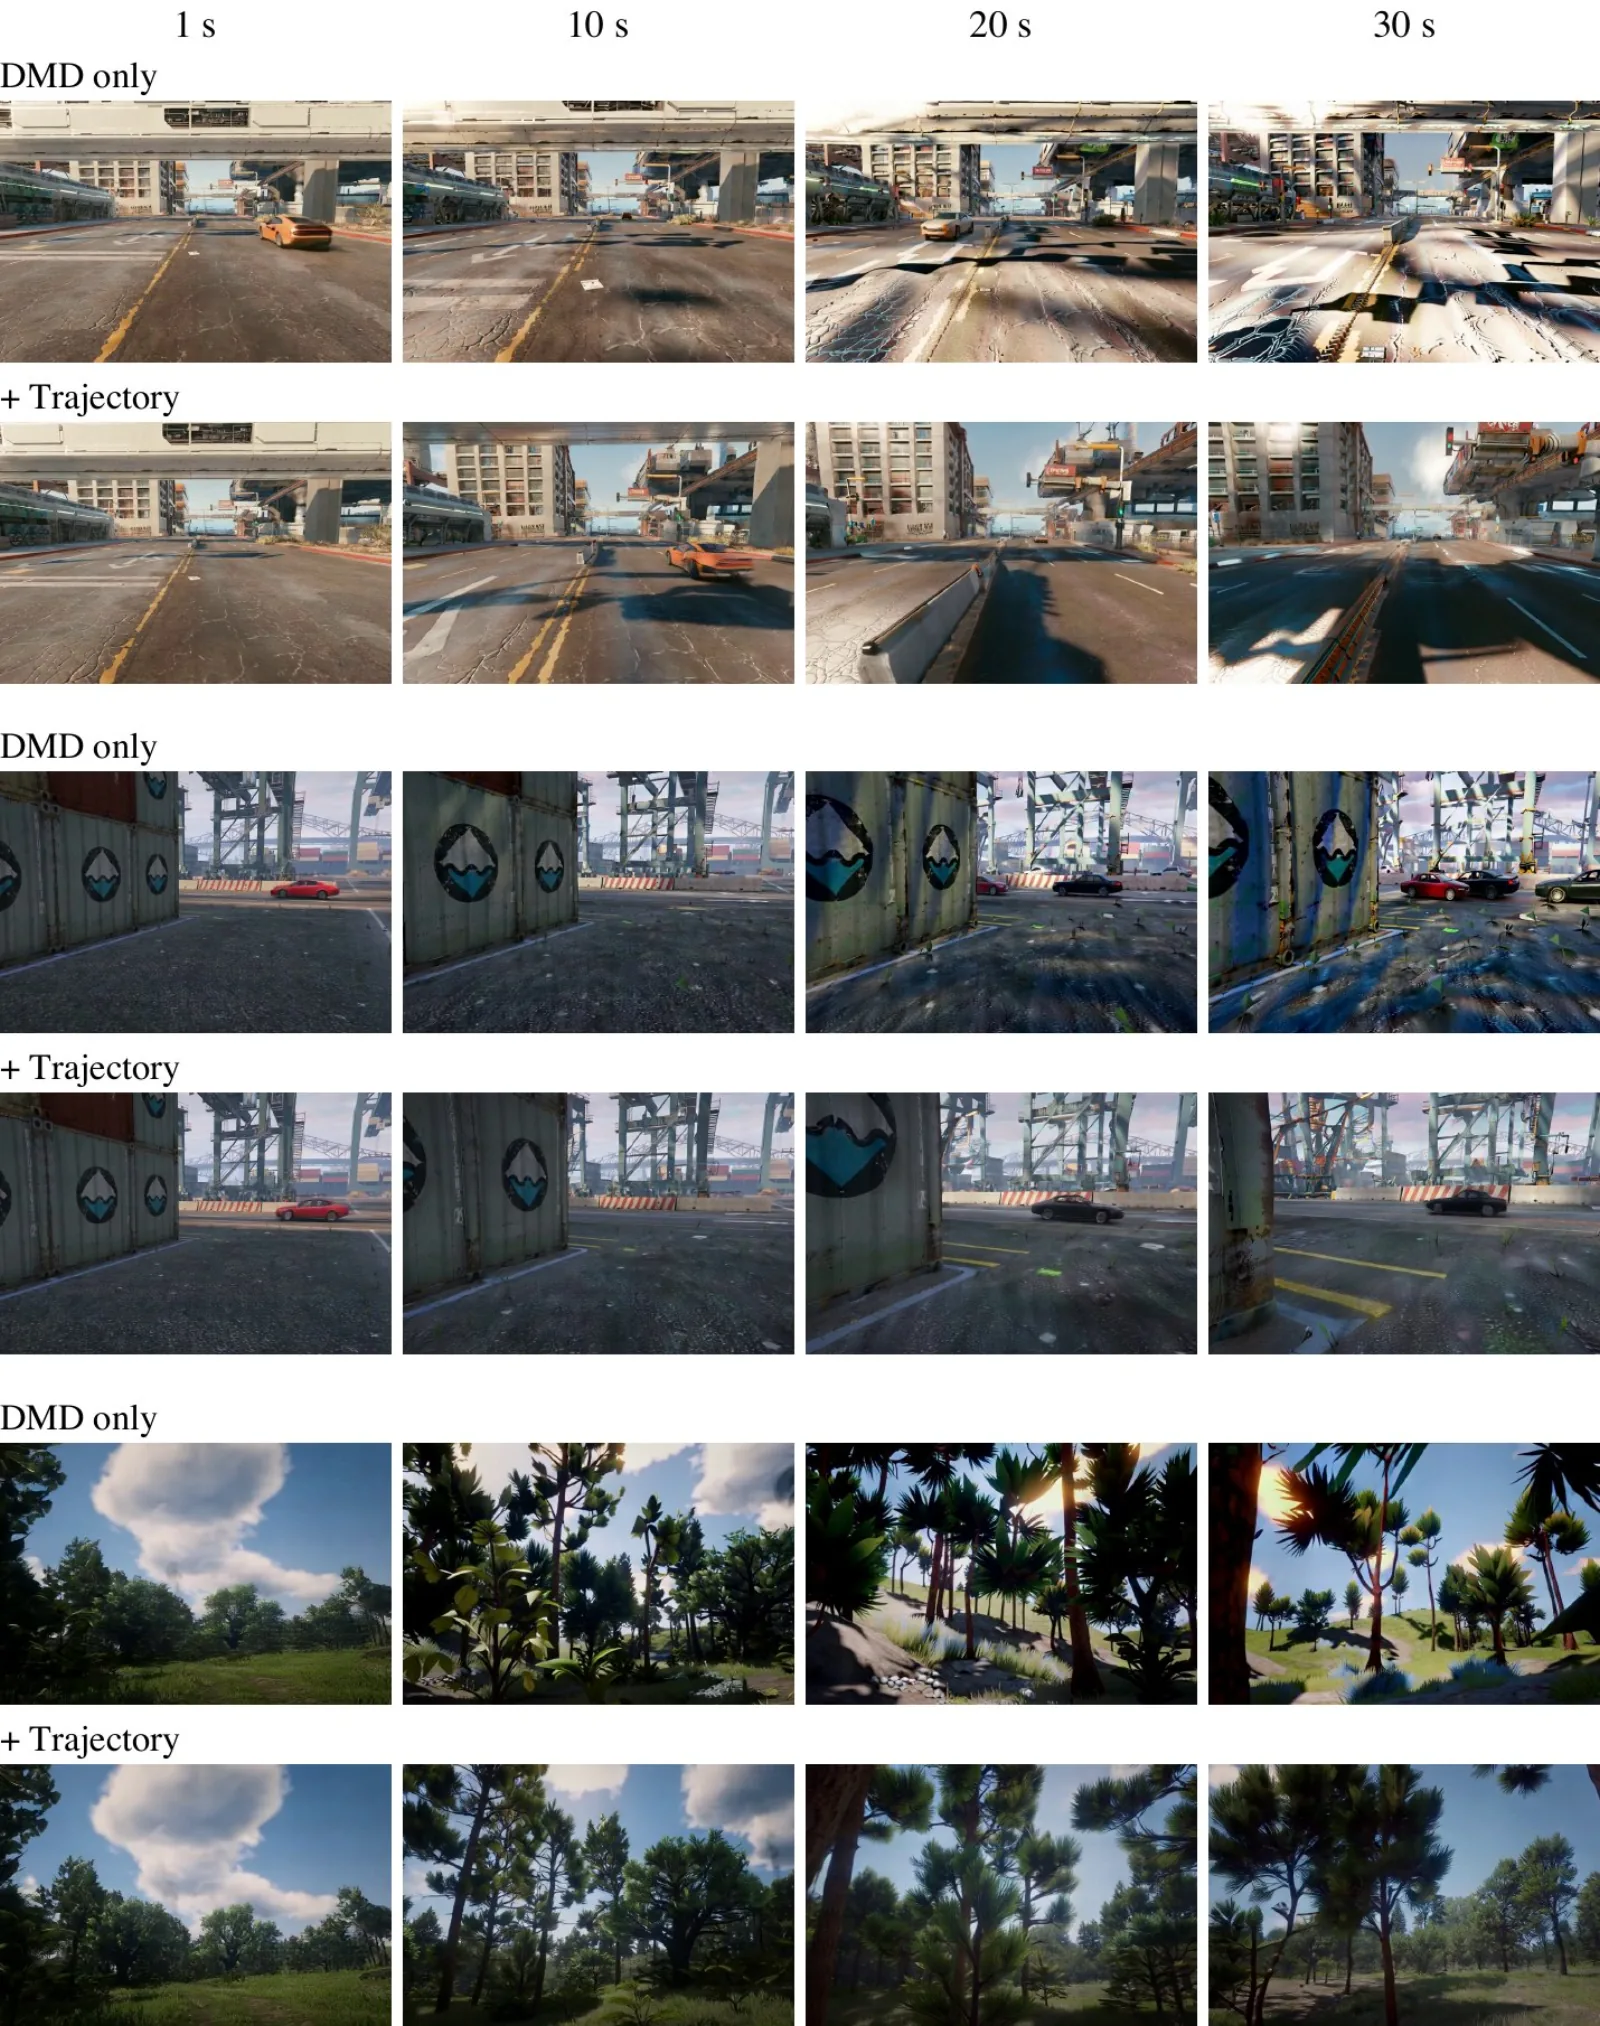
局限
输出分辨率为 768×512。实时速度在 NVIDIA H800 数据中心 GPU 上测得,论文未报告消费级显卡的表现。
公开权重是预览版。
只看画面质量,Helix World 略低于最好的无声模型(WBench 均分 79.9 对 82.0);静音观看时,用户更偏好 EchoWM。
Helix World 在 HelixBench 上的 DeSync 不是最低,起音时间的精度还有提升空间。
另一条思路是给现有世界模型补上流式立体声,参见我们的 WorldSonus 文章。
试用 Helix World
交互式 demo 已在 helixworld.org 开放。完整论文《HelixWorld: A Real-time Interactive Audio-Visual World Model》(arXiv:2609.38123,2026 年 9 月 29 日)见 arXiv。代码在 GitHub,预览版权重在 Hugging Face。
作者:Lei Ke、Jiahao Pan、Zeyue Tian(共同一作)、Jiaming Wang、Haoyuan Huang、Kam Man Wu、Pengjun Fang、Hongyu Liu、Chenyang Qi、Lin Wang、Ruibin Yuan、Weijia Chen、Fangneng Zhan、Qifeng Chen、Wei Xue、Yike Guo。通讯作者:Zeyue Tian、Wei Xue。单位:香港科技大学、Noiz AI。