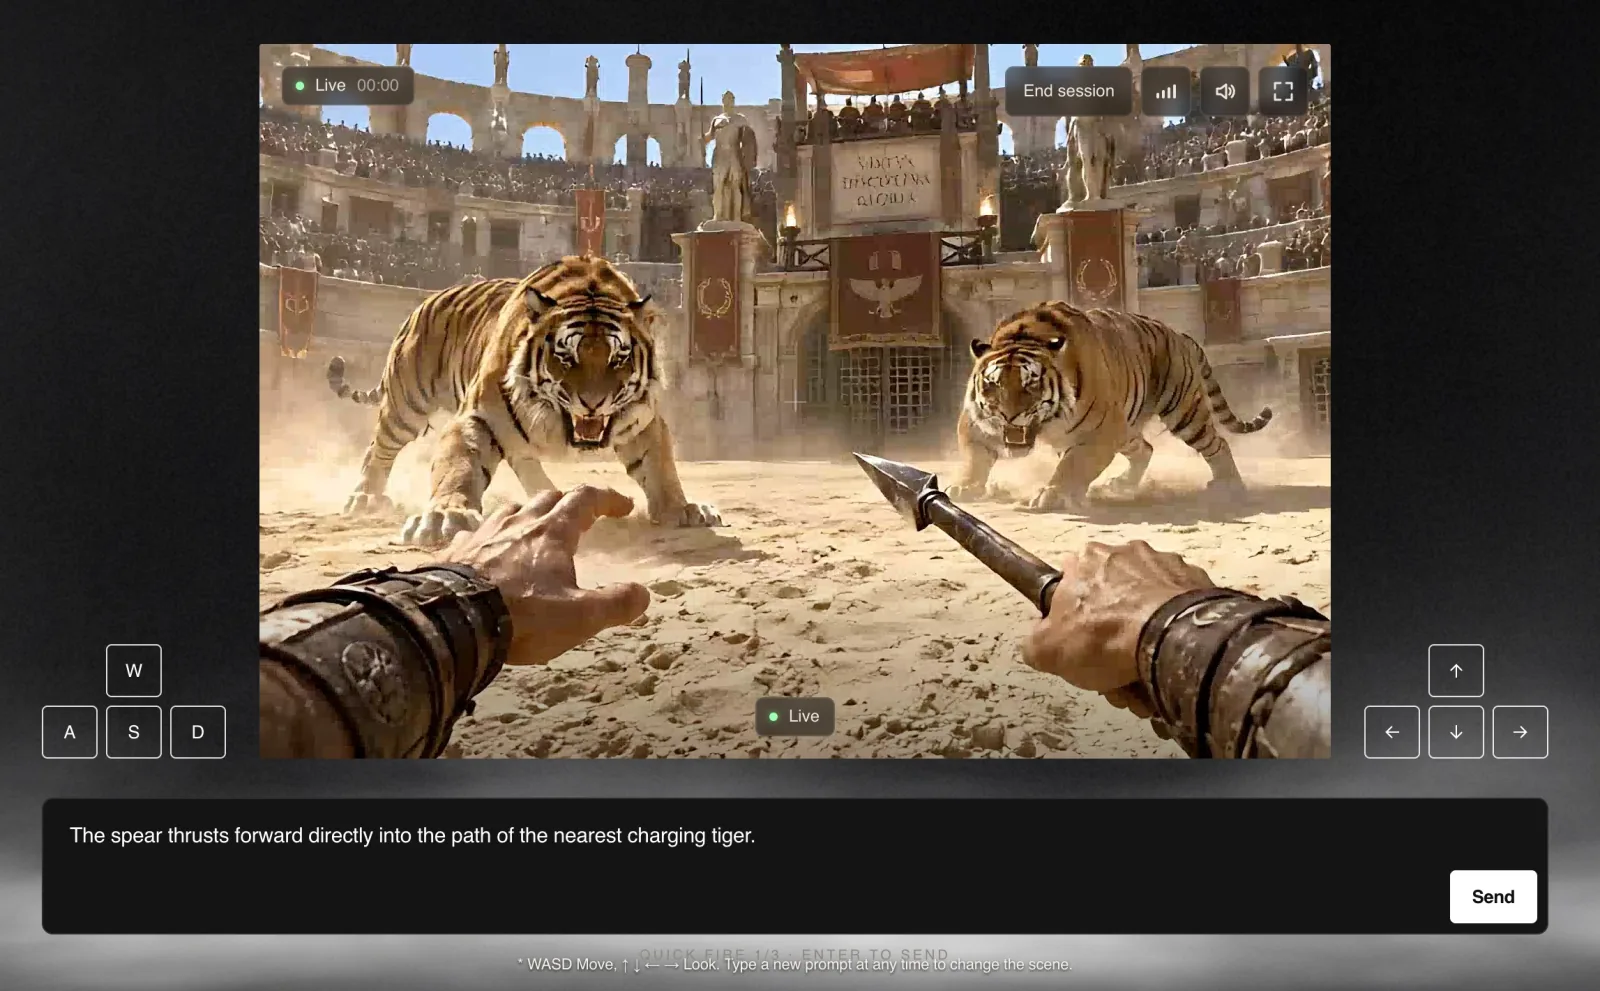
本日、Helix World を公開します。Noiz AI と香港科技大学(HKUST)が共同開発した、リアルタイムで操作できる音声・映像ワールドモデルです。1 枚の画像から始め、WASD で移動し、矢印キーで視点を変えると、モデルが次の映像とそれに合ったステレオ音声を同時に生成します。1 枚の NVIDIA H800 GPU で毎秒 24 フレームです。
Helix World は、ユーザーのカメラ移動とキー操作に応じて、探索できるシーンと空間ステレオ音声をまとめて生成するワールドモデルです。カメラが向きを変えると、音場も一緒に回ります。
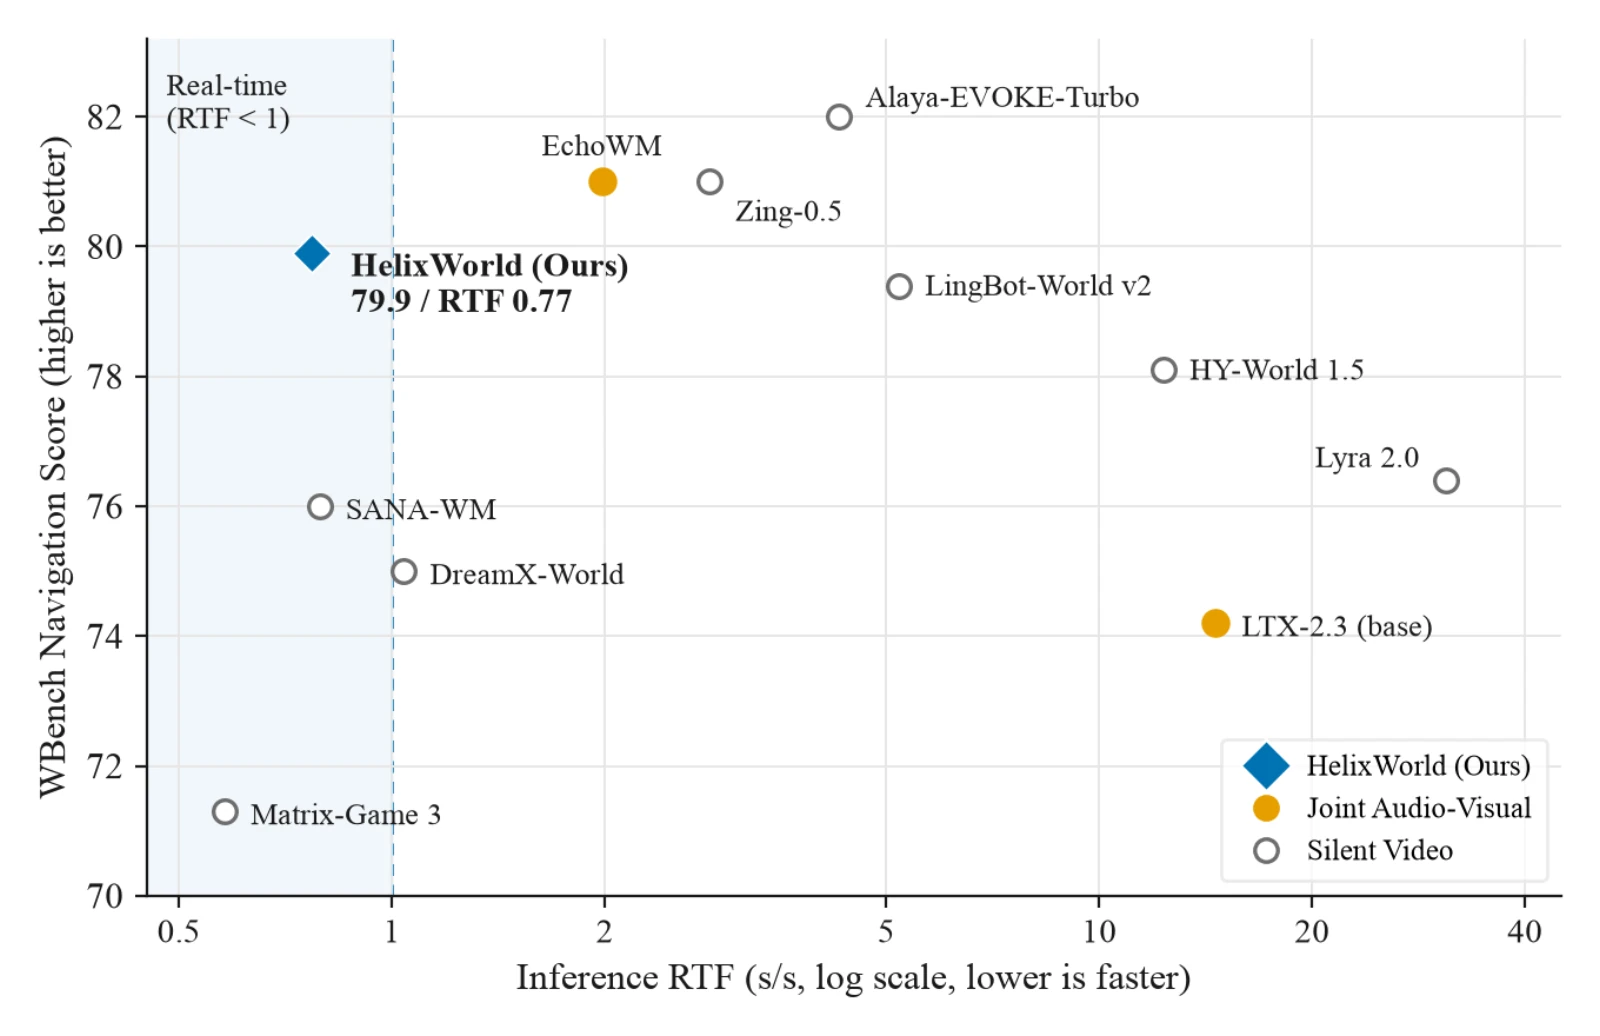
WBench のナビゲーション分割で Helix World のスコアは 79.9 と、最上位の無音ワールドモデルに迫ります。しかもリアルタイム係数(RTF)0.77 で、実時間より速く動きます。モデルと同時に公開する音声・映像ベンチマーク HelixBench では、空間音響の一貫性スコアが 41.8 でした。比較対象のうち音声を生成できる唯一のワールドモデル EchoWM は 12.7 です。論文は arXiv、コードは GitHub、プレビュー版の重みは Hugging Face で公開しており、インタラクティブデモは helixworld.org で試せます。
ワールドモデルに音が必要な理由
インタラクティブなワールドモデルでは、生成された環境をリアルタイムで操作できます。しかし、その多くは無音です。音は映像にない情報を運びます。表面の材質、物がぶつかる強さ、画面の外で起きていること。没入感のあるシーンでは、振り向けば音も左右の耳の間で動くべきです。
後から音を付けるだけでは解決しません。カスケード型の映像→音声(V2A)モデルはカメラ軌跡もユーザー操作も見ないため、音が視点の動きに追従せず、映像の後に処理するぶん遅延も増えます。双方向の音声・映像基盤モデルは両方を生成できますが操作インターフェースがなく、そのまま因果的なストリーミング生成に変えると誤差が積み重なり、映像も音も崩れていきます。Helix World は、学習データの不足、操作性の欠如、長時間生成のドリフトという 3 つの課題にまとめて取り組みました。
生成された世界をリアルタイムで探索
デモでは開始画像を選ぶか、自分の画像をアップロードします。画像は 768×512 にエンコードされます。テキストプロンプトは任意で、空欄ならフレームから自動でシーンが記述されます。セッションが始まったら、WASD でカメラを動かし、矢印キーで視点を変えます。生成は約 1.3 秒ごとのチャンク単位で進み、キー入力や新しいプロンプトは次のチャンクから反映されるので、実行中でも展開を変えられます。
ベンチマーク
映像品質と速度
映像品質と操作への追従は WBench のナビゲーション分割で評価しました。リアルタイム係数は、出力映像 1 秒あたりに必要な計算秒数です。1 枚の NVIDIA H800 で、映像と音声のデコードを含めて測定しています。1.0 未満なら実時間より高速です。論文の表 3:
モデル | ネイティブ音声 | RTF(H800)↓ | WBench 平均 ↑ |
|---|---|---|---|
Alaya-EVOKE-Turbo | なし | 4.29 | 82.0 |
EchoWM | あり | 1.98 | 81.0 |
Zing-0.5 | なし | 2.81 | 81.0 |
Helix World | あり | 0.77 | 79.9 |
LingBot-World v2 | なし | 5.21 | 79.4 |
SANA-WM | なし | 0.79 | 76.0 |
LTX-2.3(ベース) | あり | 14.61 | 74.2 |
Matrix-Game 3 | なし | 0.58 | 71.3 |
実時間より速いモデルの中で、Helix World のスコアが最も高く 79.9 です(SANA-WM は 76.0、Matrix-Game 3 は 71.3)。上位 3 モデルは映像 1 秒あたり 1.98〜4.29 秒の計算が必要で、そのうち 2 つは無音です。表の中で、リアルタイムかつ音声も生成できるのは Helix World だけです。
カメラに追従する音
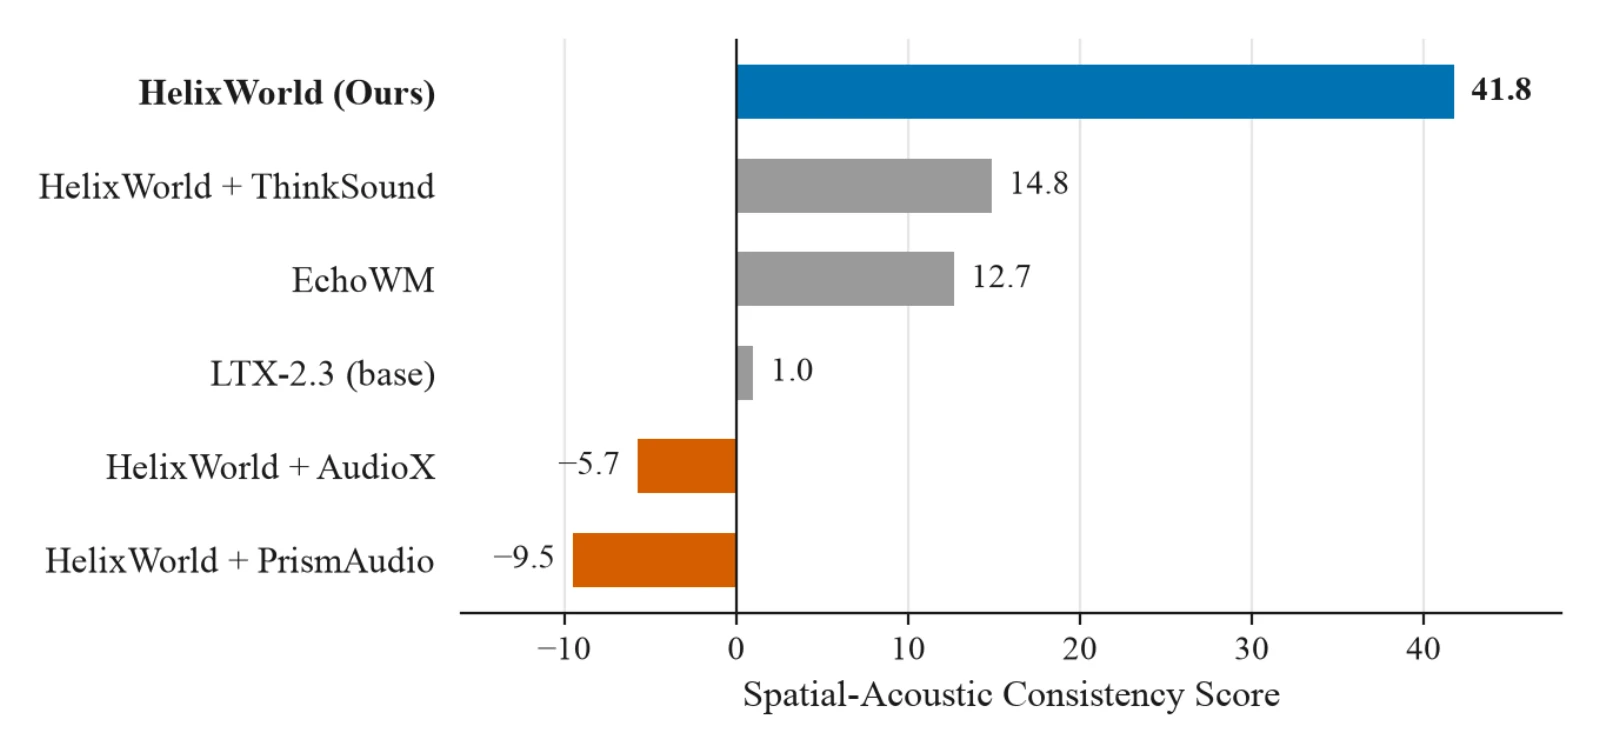
既存のワールドモデル用ベンチマークは映像しか評価せず、音声・映像ベンチマークはカメラが動かない短いクリップしか使いません。HelixBench はその空白を埋めるもので、6 つのドメインと 4 つのサブセット(ナビゲーション、視点、イベント、被写体)にわたる 1,015 件の人手検証済みケースで構成されます。各ケースには開始フレーム、音声・映像プロンプト、連続したカメラ姿勢、ステレオの参照音声が含まれます。空間スコアは、画面上の音源の位置と左右のステレオ定位の相関をとり、音場がカメラと一緒に回っているかを直接測ります。
比較対象は EchoWM と、Helix World の映像を無音にして V2A モデル(AudioX、ThinkSound、PrismAudio)で音を付け直したカスケード構成です。映像は固定し、音声だけを比べます。論文の表 4:
モデル | KL ↓ | FAD ↓ | DeSync(秒)↓ | ImageBind ↑ | CLAP ↑ | 空間 ↑ |
|---|---|---|---|---|---|---|
Helix World(因果的スチューデント) | 1.39 | 2.39 | 0.59 | 0.299 | 0.302 | 41.8 |
Helix World(双方向ティーチャー) | 1.54 | 3.08 | 0.50 | 0.270 | 0.268 | 33.2 |
EchoWM | 1.95 | 7.75 | 0.67 | 0.204 | 0.235 | 12.6 |
Helix World + ThinkSound | 2.23 | 6.19 | 0.42 | 0.208 | 0.289 | 14.8 |
Helix World + AudioX | 2.02 | 3.92 | 1.18 | 0.257 | 0.309 | −5.7 |
Helix World + PrismAudio | 2.24 | 6.39 | 0.46 | 0.215 | 0.272 | −9.5 |
LTX-2.3(ベース) | 1.80 | 7.64 | 0.40 | 0.278 | 0.258 | 1.0 |
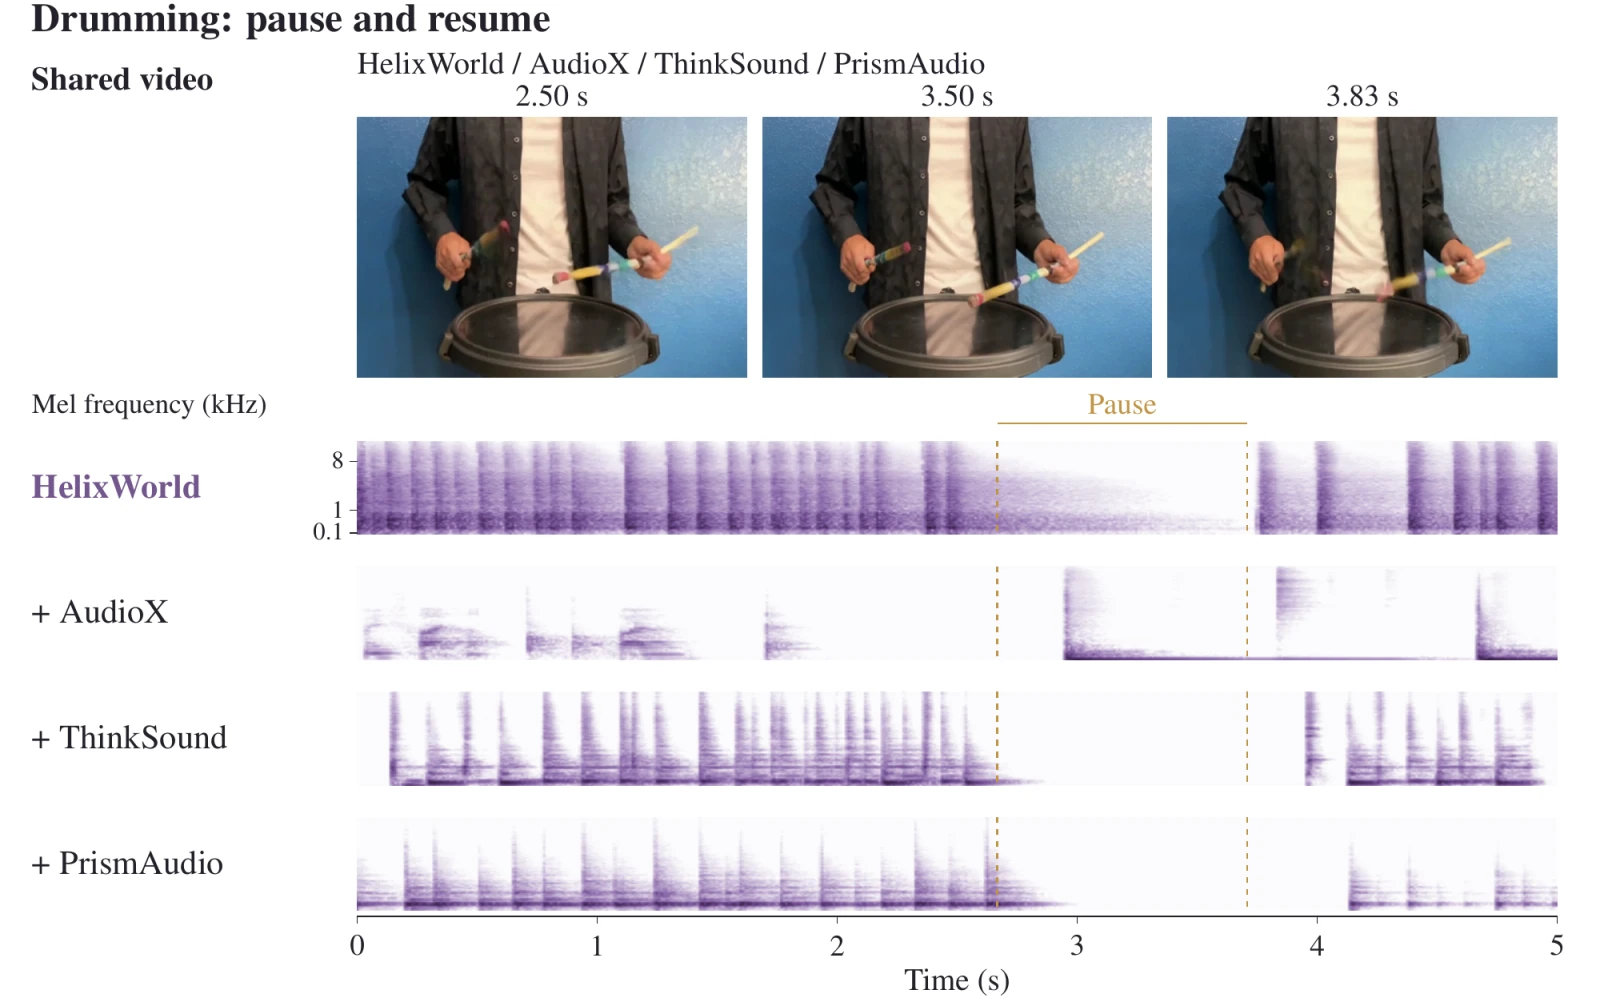
Helix World は音声の忠実度(KL、FAD)、音声と映像の意味的な整合(ImageBind)、空間の一貫性で首位です。ただし全項目ではありません。時間のずれ(DeSync)は LTX-2.3 と ThinkSound 構成のほうが小さく、テキストと音声の整合(CLAP)は AudioX 構成がわずかに上です。付け直し構成の空間スコアがマイナスになるのは、V2A モデルが音源とカメラの位置関係を知らないためです。
ユーザーはどちらを選んだか
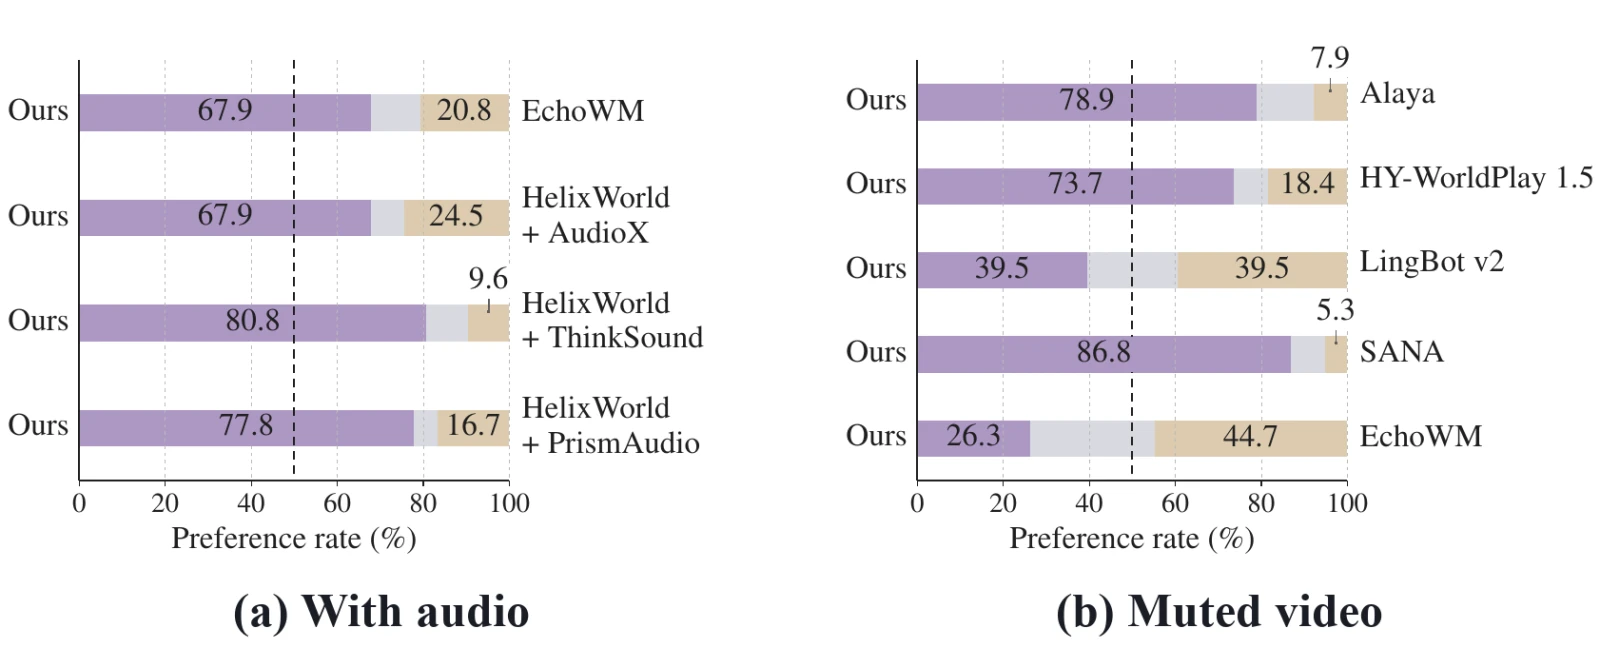
音声付きの完全な生成結果を使ったユーザー調査では、Helix World が EchoWM に対して 67.9% 対 20.8% で好まれました。同じ映像に音を付け直した版に対しては、67.9% 対 24.5%(AudioX)、80.8% 対 9.6%(ThinkSound)、77.8% 対 16.7%(PrismAudio)で、残りは引き分けです。音を消した場合、Helix World は SANA-WM、Alaya、HY-WorldPlay 1.5 より好まれ、LingBot-World v2 とは 39.5% ずつで引き分け、EchoWM には 26.3% 対 44.7% で及びませんでした。優位性の大部分は音声から来ています。
Helix World のつくり方
データ:本物のステレオとメートル単位のカメラ姿勢
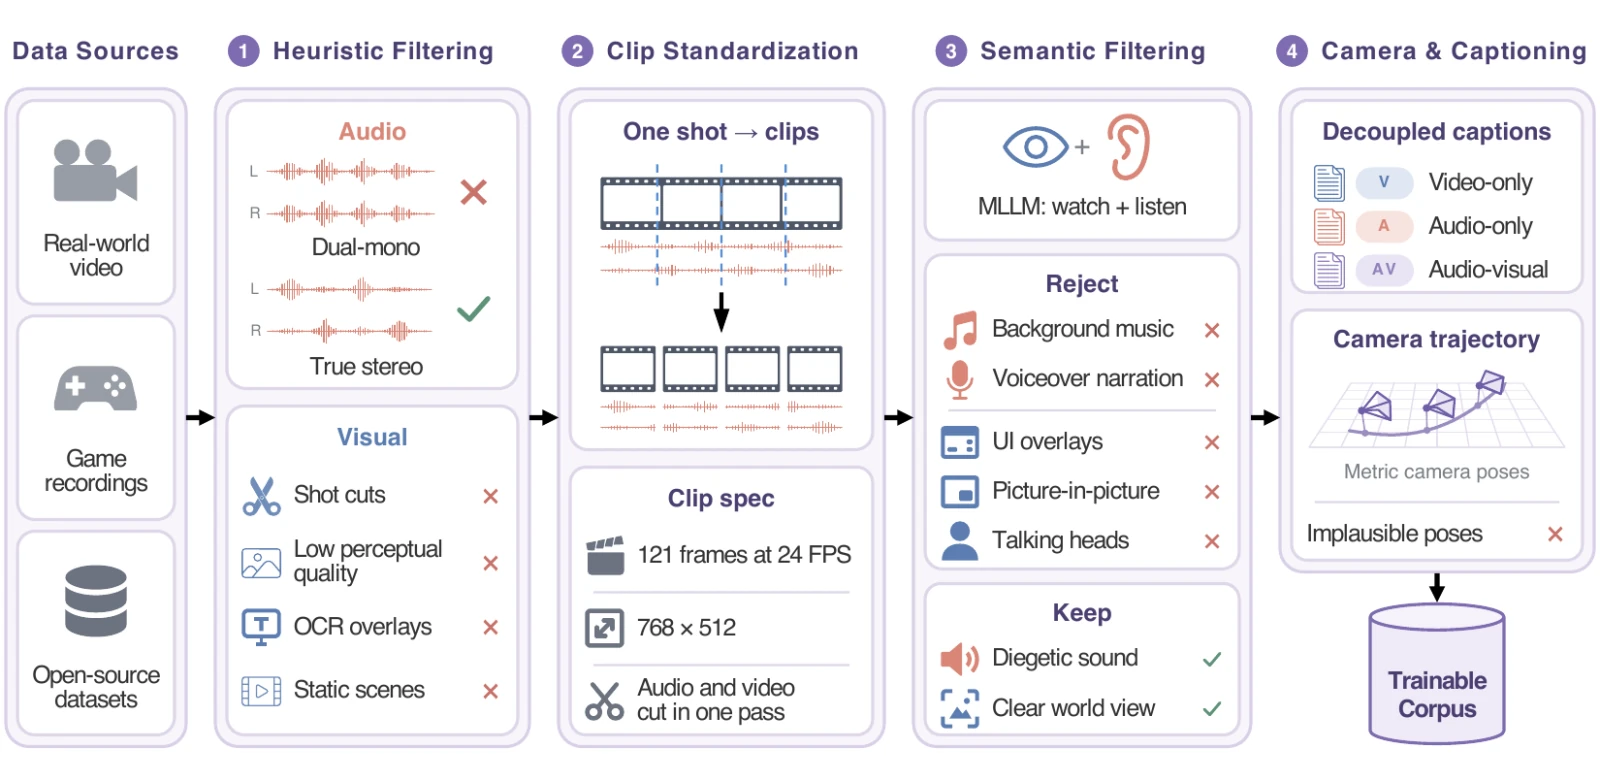
多くの映像コーパスはこのタスクに使えません。音声トラックが BGM やナレーション、あるいは左右が同じ疑似ステレオであることが多いためです。私たちは 4,100 時間の素材(実写映像 43.9%、ゲーム録画 34.1%、オープンソースデータセット 22.0%)から始め、計算コストの低い順に 4 段階でふるいにかけました。
ヒューリスティックなフィルタリング:デュアルモノラル音声、カット切り替え、低画質、文字のオーバーレイ、静止したシーンを除外。
クリップの標準化:音声と映像をまとめて 121 フレーム、24 fps、768×512 のクリップに切り出し、48 kHz ステレオを付与。
意味によるフィルタリング:映像を見て音を聞くマルチモーダル LLM が、BGM、ナレーション、UI オーバーレイ、ピクチャーインピクチャー、話者のアップを除外し、その場の音を残す。
カメラとキャプション:全フレームのメートル単位のカメラ姿勢を復元し、映像のみ・音声のみ・音声と映像の 3 トラックのキャプションを付与。
結果は 3,000 時間、210 万クリップで、歩留まりは 73.1% です。アブレーションでは、3 トラックのキャプションで学習したときに音声と映像の整合が最も高くなりました。
カメラとアクションで操作できる双方向ティーチャー
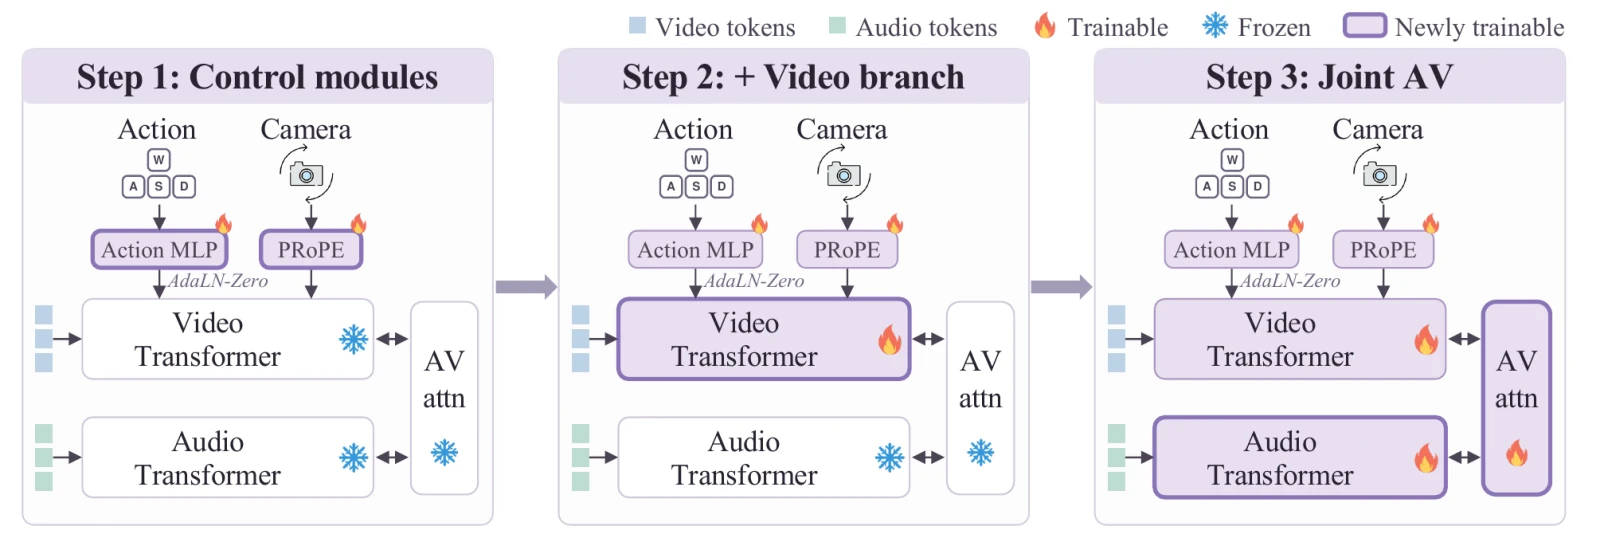
Helix World はオープンソースの音声・映像モデル LTX-2.3 をベースにしています。連続した 6 自由度のカメラ軌跡は PRoPE で映像の注意機構に、離散的なキー操作は拡散タイムステップ上の AdaLN-Zero で注入します。さらにクロスモーダル注意が映像の幾何と音声の特徴を結びつけ、カメラの動きがステレオ定位の移動になります。
学習は段階的に行います。まず操作モジュール、次に映像ブランチ、最後に音声・映像の主幹全体です。最初から全体をファインチューニングする場合と比べ、カメラの回転誤差は 0.1237 から 0.1144 に、並進誤差は 0.0957 から 0.0823 に下がり、事前学習済みの映像品質も保たれました。
ドリフトせずにストリーミングする因果的スチューデント
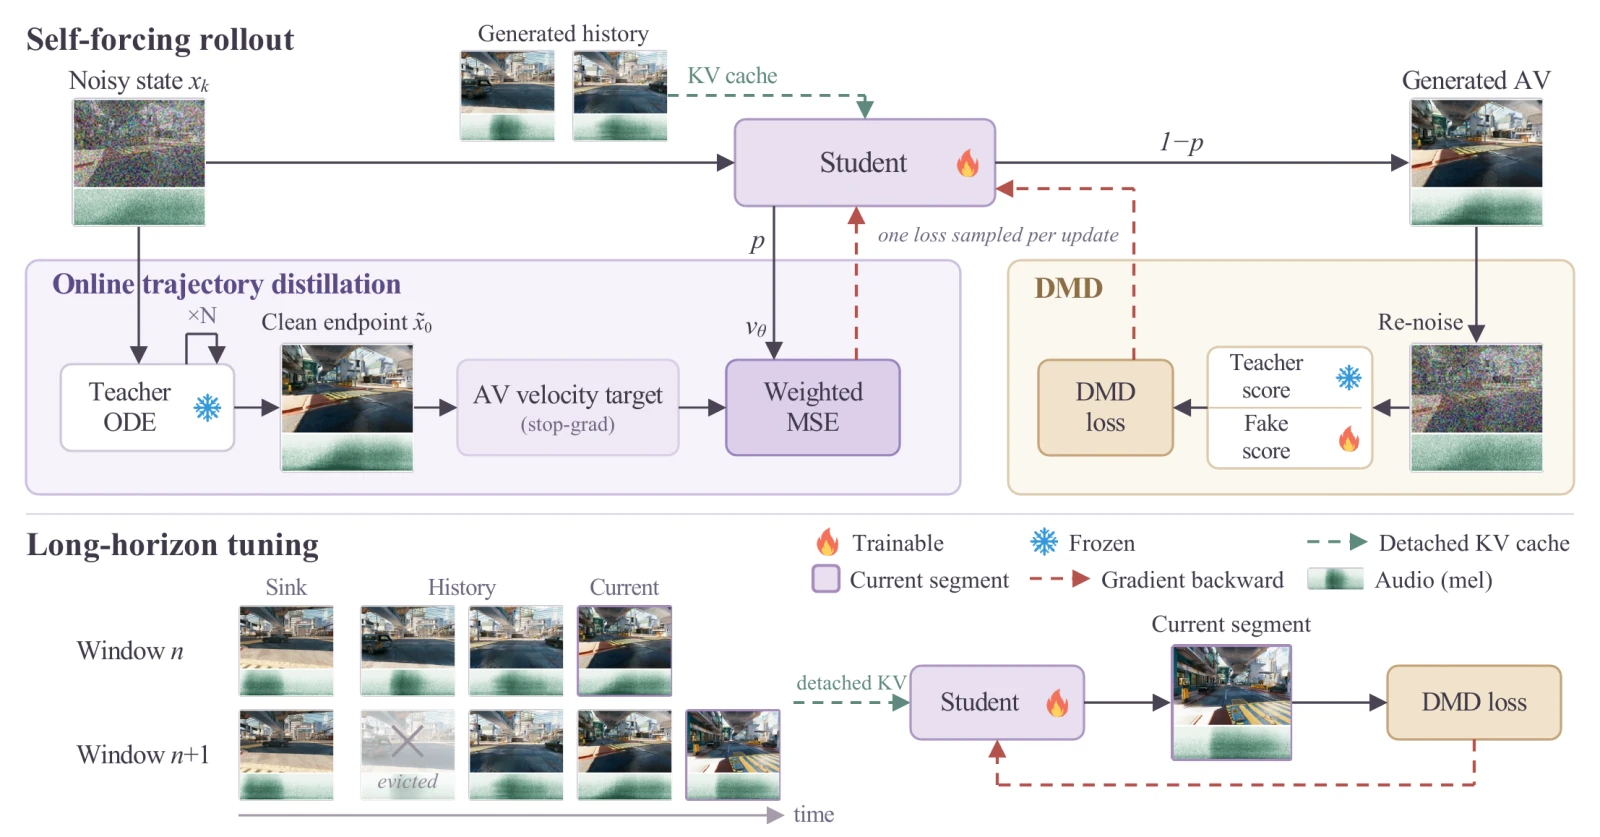
双方向ティーチャーはクリップ全体を一度に見るため、ライブ入力に反応できません。そこで少ステップの因果的スチューデントに蒸留します。スチューデントはブロック単位で生成し、スライディング KV キャッシュと固定の sink フレームを使います。まずティーチャーの ODE 出力への回帰で初期化し、その後、自分の生成結果に対して self-forcing で学習します。
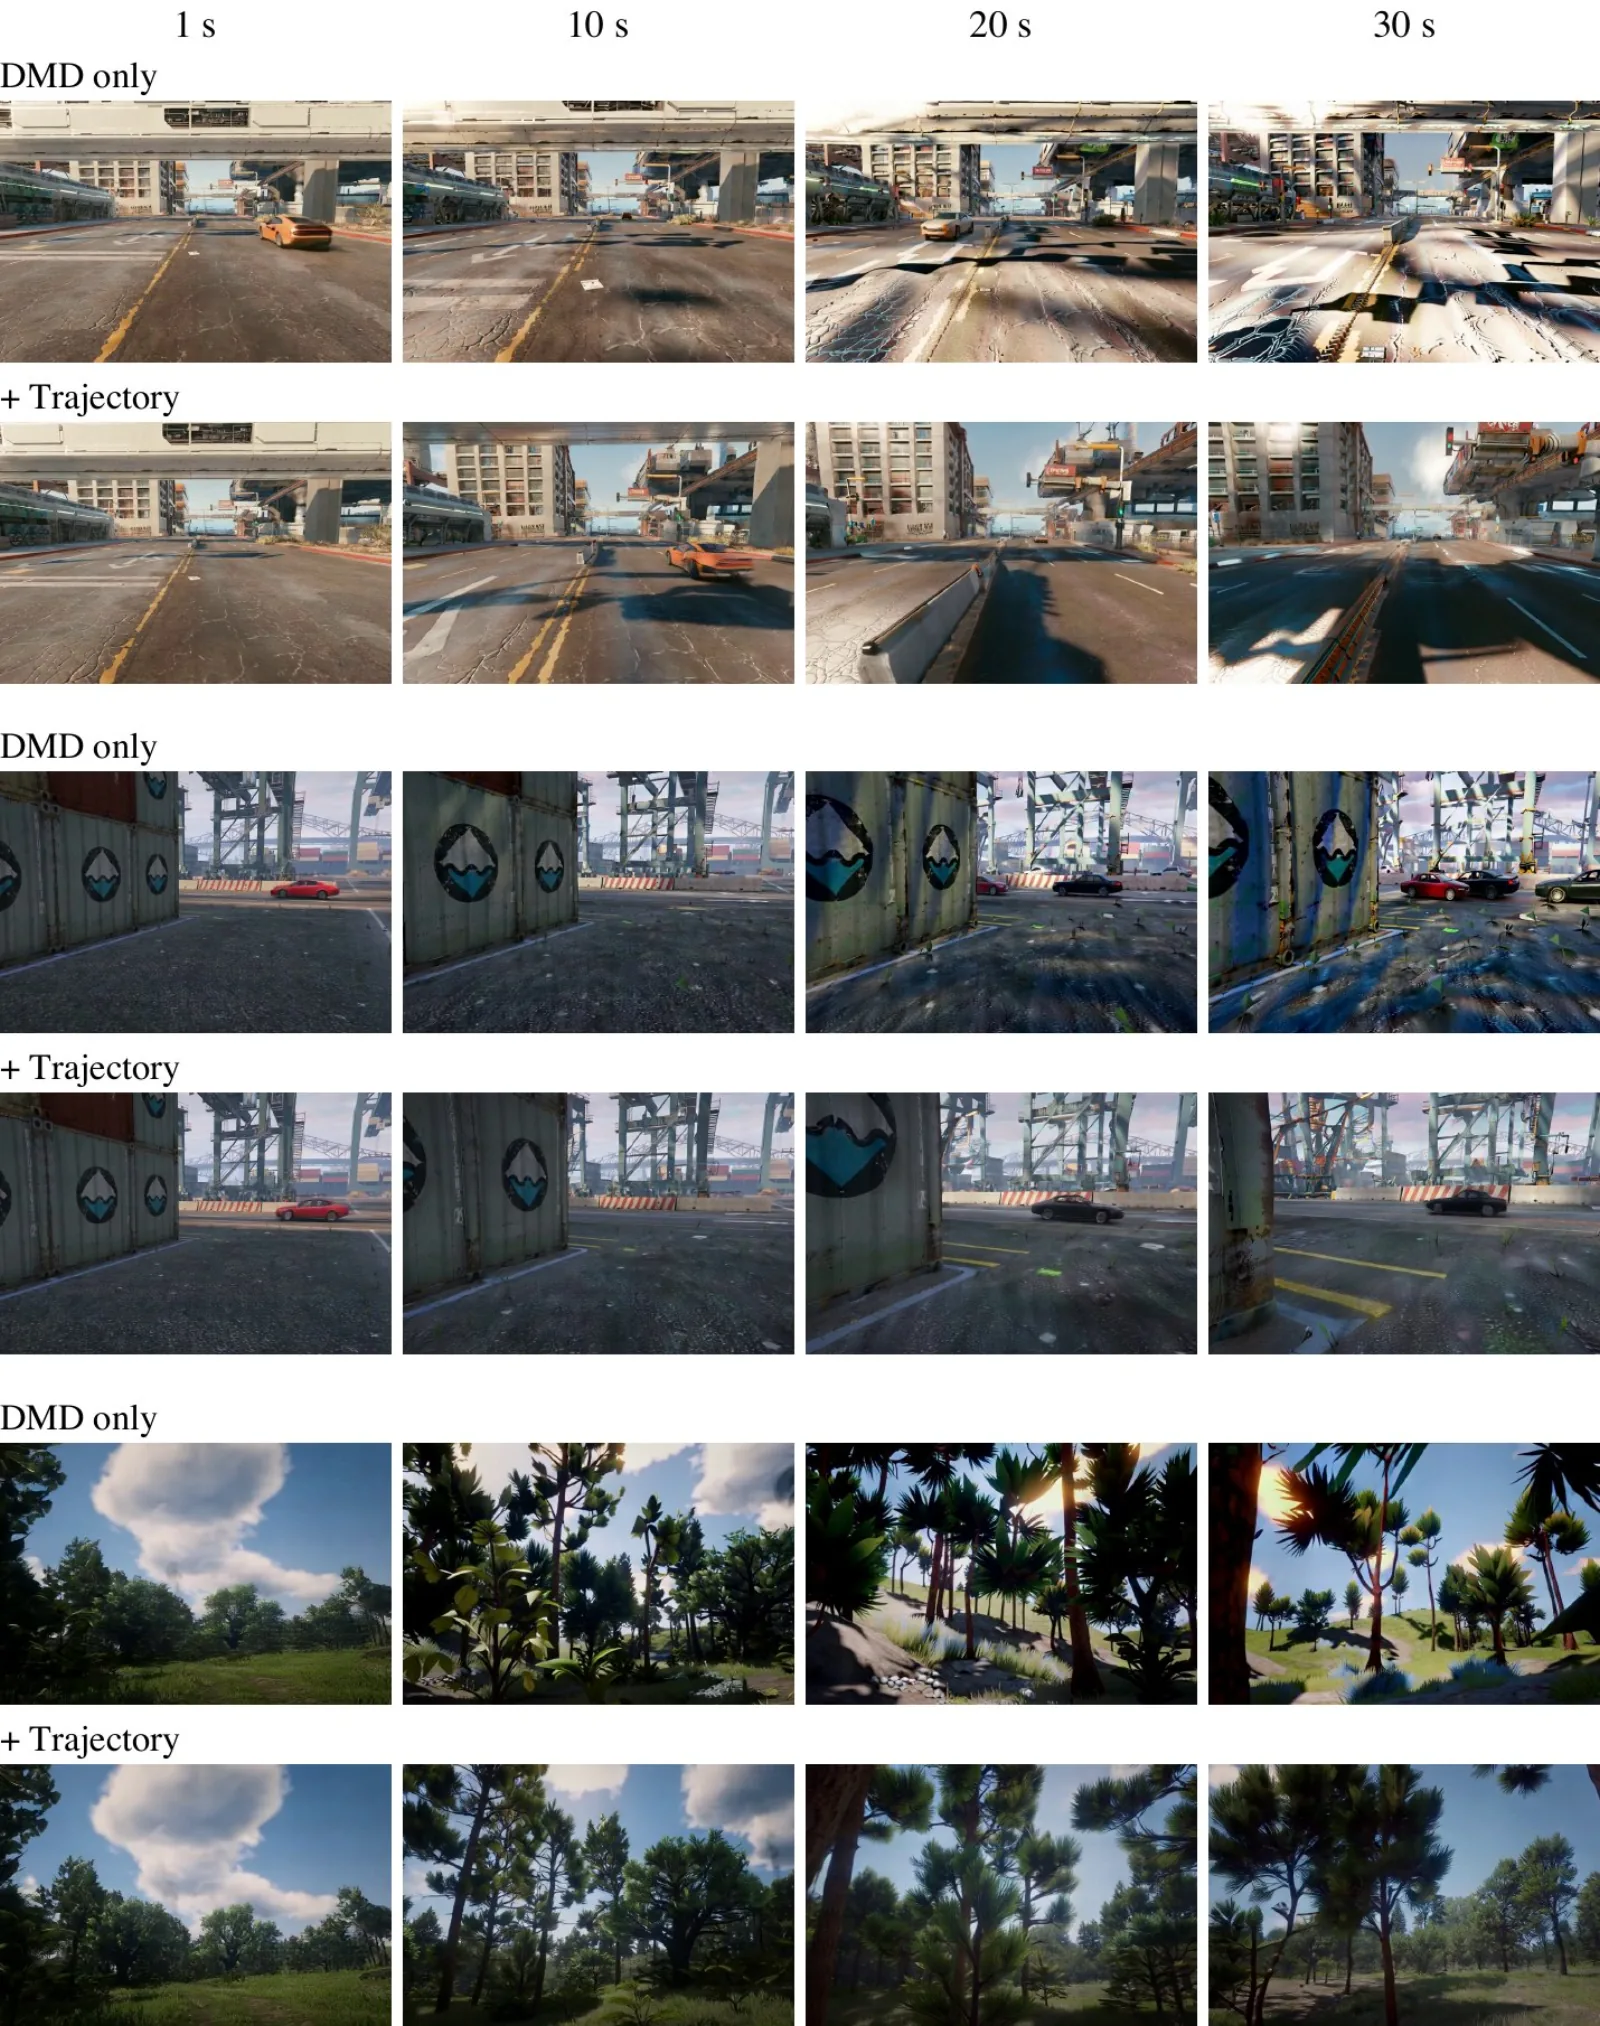
分布マッチング蒸留(DMD)だけの self-forcing では、長い生成でまだドリフトが起きます。そこでオンライン軌跡蒸留の損失を加えました。各更新で、確率 p で中間状態におけるスチューデントの速度をティーチャーの確率流 ODE の目標で教師付けし、それ以外は DMD 損失を使います。最後に長時間ストリーミングの学習段階を設けます。これらを合わせて WBench スコアは 77.9 から 79.1 に上がり、30 秒の生成も安定しました。
制約
出力解像度は 768×512 です。リアルタイム速度は NVIDIA H800 データセンター GPU での測定で、コンシューマー GPU の結果は論文にありません。
公開している重みはプレビュー版です。
映像品質だけを見ると、Helix World は最上位の無音モデルにわずかに届きません(WBench 平均 79.9 対 82.0)。音を消した比較では EchoWM が好まれました。
HelixBench の DeSync は最小ではなく、発音タイミングの精度には改善の余地があります。
既存のワールドモデルにストリーミングでステレオ音声を後付けする別のアプローチについては、WorldSonus の記事をご覧ください。
Helix World を試す
インタラクティブデモは helixworld.org で公開中です。論文「HelixWorld: A Real-time Interactive Audio-Visual World Model」(arXiv:2609.38123、2026 年 9 月 29 日)の全文は arXiv で読めます。コードは GitHub、プレビュー版の重みは Hugging Face にあります。
著者:Lei Ke、Jiahao Pan、Zeyue Tian(同等貢献)、Jiaming Wang、Haoyuan Huang、Kam Man Wu、Pengjun Fang、Hongyu Liu、Chenyang Qi、Lin Wang、Ruibin Yuan、Weijia Chen、Fangneng Zhan、Qifeng Chen、Wei Xue、Yike Guo。責任著者:Zeyue Tian、Wei Xue。所属:香港科技大学、Noiz AI。