Publicamos WorldSonus. Mientras un modelo de mundo sigue dibujando el vídeo a trozos, puede ponerle estéreo al mismo tiempo: sale un tramo de imagen y, justo detrás, un tramo de sonido.
Cada fragmento son 100 milisegundos de estéreo a 48 kHz. El artículo midió 41.2 milisegundos por fragmento en una sola NVIDIA H100. El factor de tiempo real es 0.41. El artículo, el código y los pesos ya son públicos. En Noiz Studio todavía no está.
Los modelos de mundo suelen ser mudos
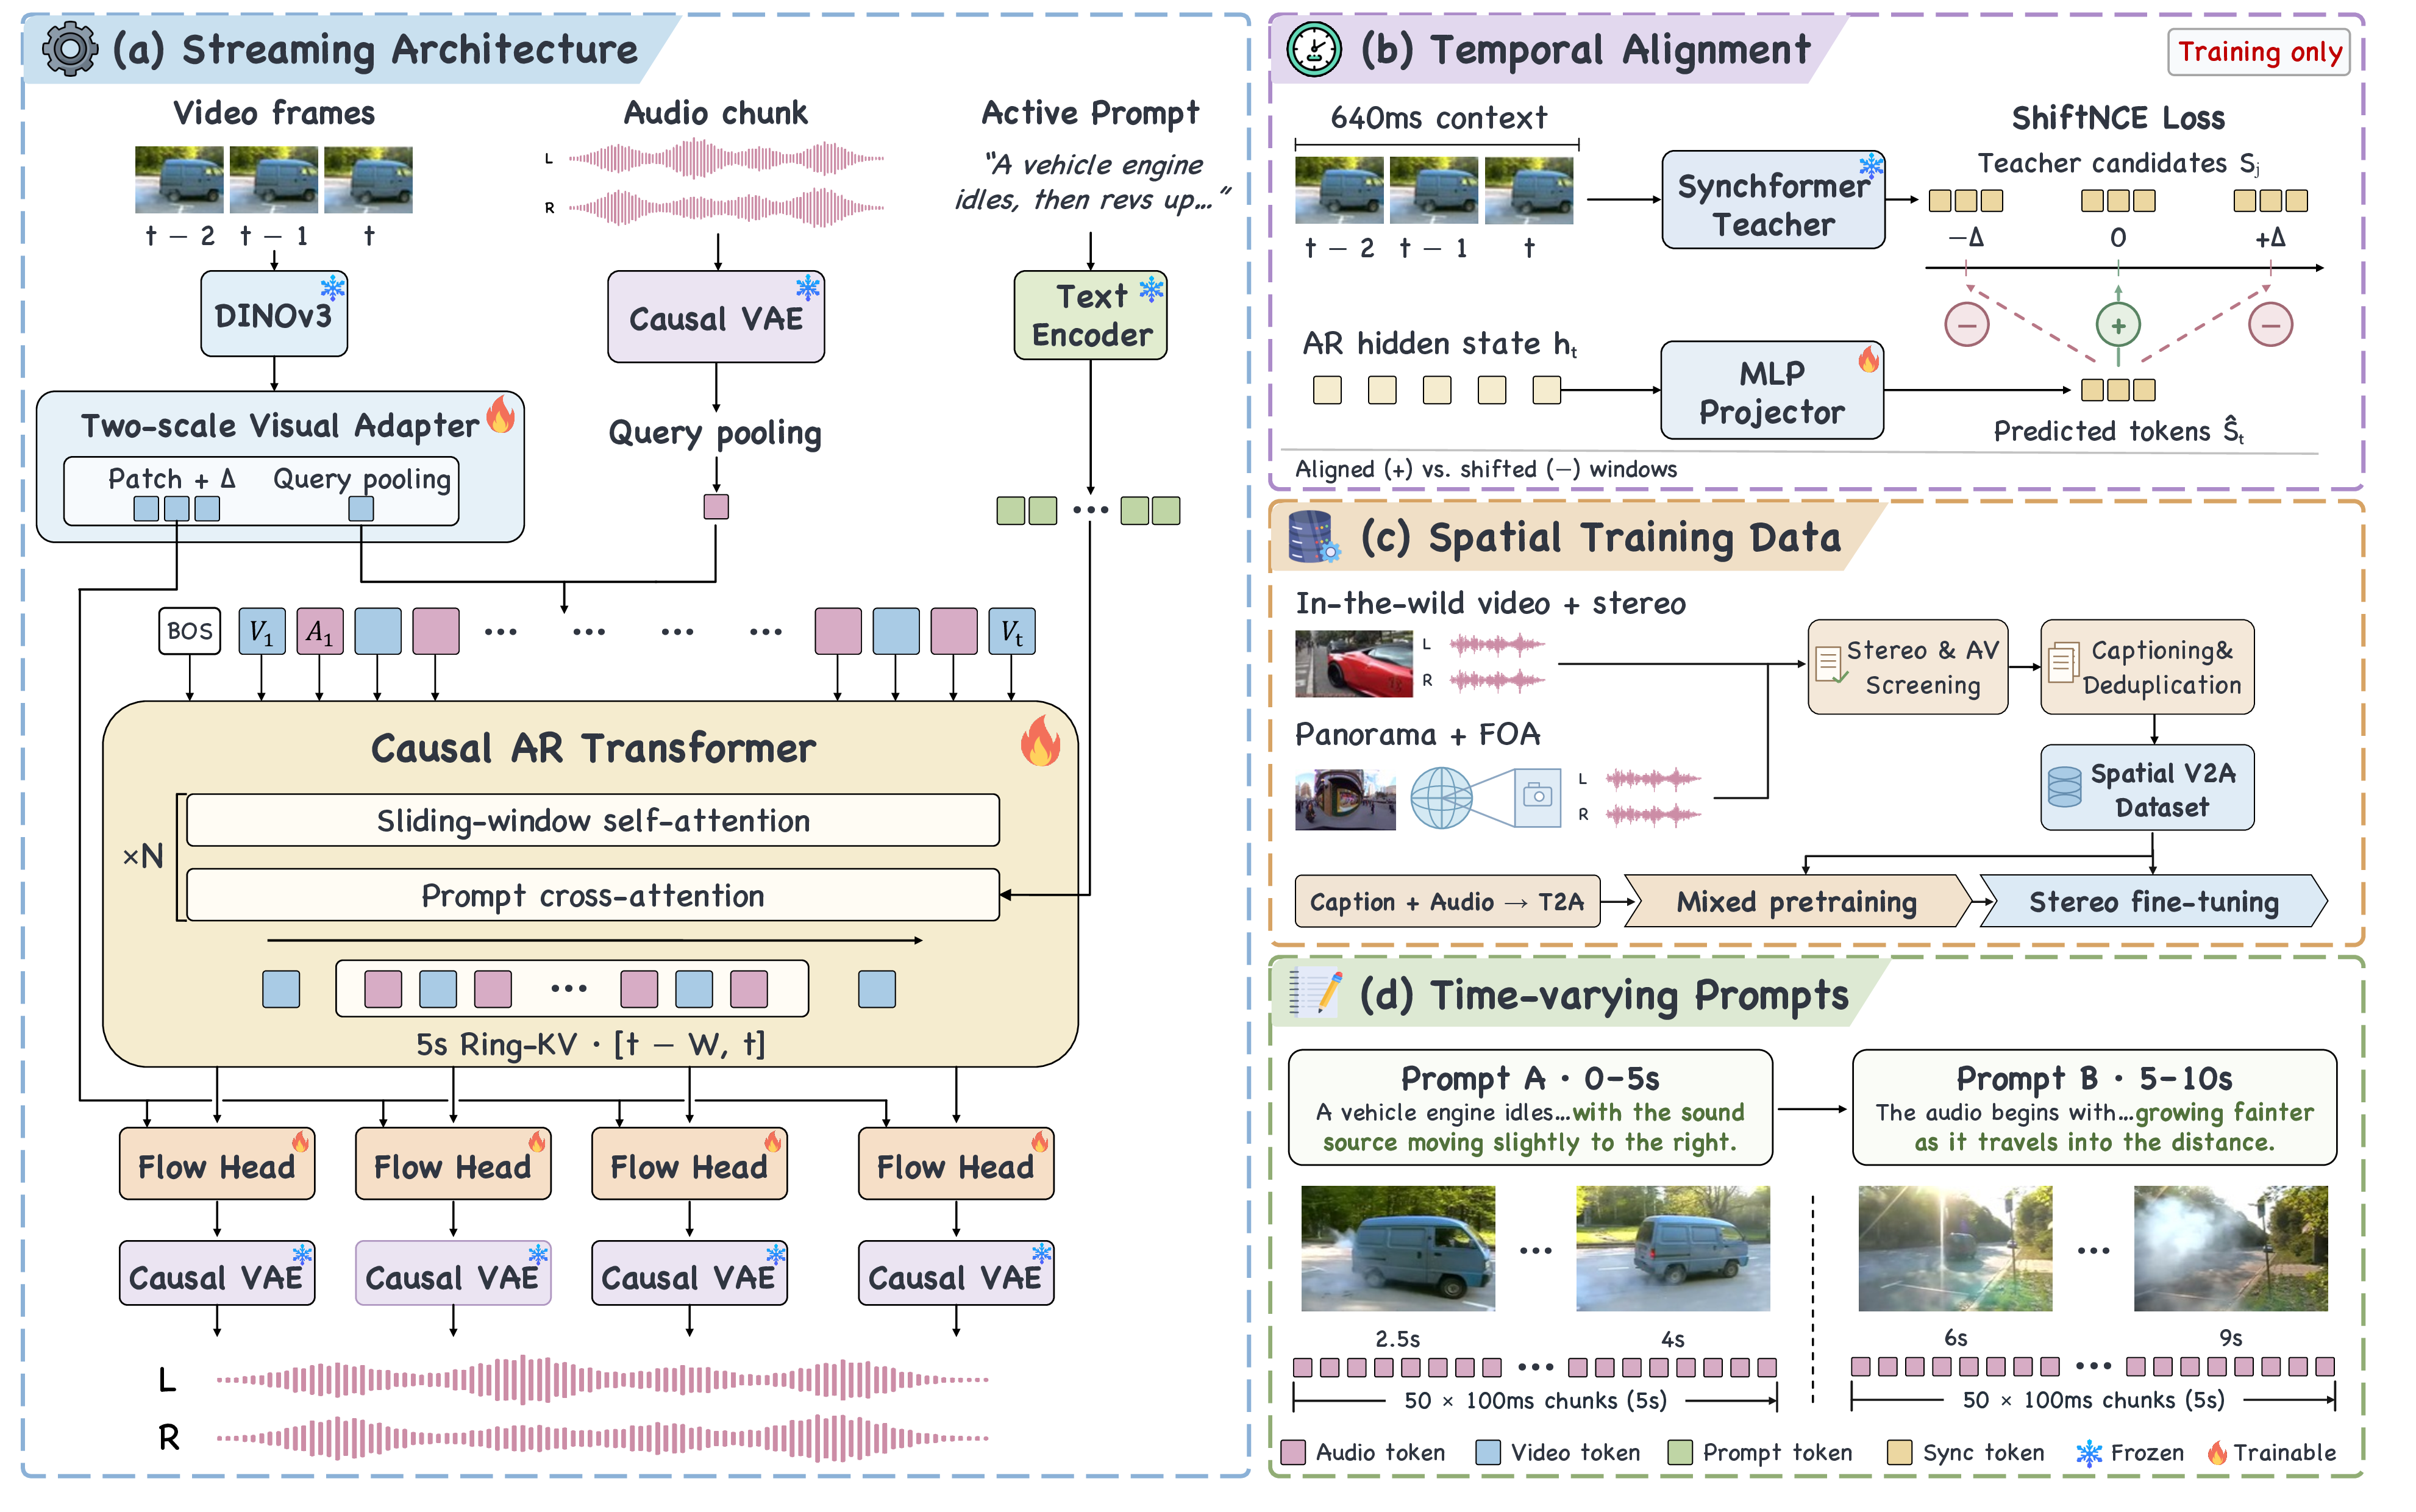
Un modelo de mundo puede seguir generando un entorno, pero lo que entrega suele ser solo imagen. WorldSonus se pone detrás y escribe el sonido. Mira los fotogramas que ya llegaron y la instrucción de sonido que das ahora, y escribe el siguiente canal izquierdo y derecho. Los fotogramas que aún no salieron no los ve.
Los autores son de la Universidad de Ciencia y Tecnología de Hong Kong, Noiz, MetaX y la Universidad Jiao Tong de Shanghái. Los autores de correspondencia son Zeyue Tian y Qifeng Chen. La lista completa está en el artículo.
Cómo el sonido sigue a la imagen
No espera a que el vídeo esté entero. El sonido llega hasta donde haya llegado la imagen.
Solo 100 milisegundos cada vez
Cada fragmento son 100 milisegundos de estéreo a 48 kHz. Eso coincide con tres fotogramas de un vídeo a 30 fps. El códec estéreo interno también corre a 30 Hz, así que un fragmento de sonido son tres fotogramas internos.
El modelo solo guarda los últimos 5 segundos, 50 fragmentos. Cuando el anillo se llena, tira el más viejo. Un vídeo más largo no hace crecer la memoria sin parar.
Se puede cambiar la instrucción a mitad de camino
Si quieres otro sonido, espera al siguiente tramo de 100 milisegundos y cámbialo. Lo ya escrito se queda. Los fotogramas anteriores no se recalculan. En los clips de entrenamiento de 10 segundos, el 60% cambia la instrucción a los 5 segundos.
Los oídos izquierdo y derecho siguen a la cámara
La salida es un canal izquierdo y uno derecho que siguen a una cámara en perspectiva. No es mono copiado dos veces. El entrenamiento usó 1465 horas de audio: 999 horas de vídeo con estéreo y 466 solo de audio. El estéreo sale de dos tipos de datos: grabaciones reales filtradas, y surround panorámico pasado a la vista de la cámara.
El modelo de vídeo de delante solo tiene que pasar los fotogramas que ya dibujó. No abre su estado interno. SwanSphere hace vídeo panorámico y surround. WorldSonus hace estéreo en tiempo real para una cámara normal.
La imagen se lee por dos caminos
DINOv3 lee la imagen. Un camino hace un resumen un poco más largo, para que el modelo retenga el suceso sonoro. El otro manda estos tres fotogramas a la cabeza de generación, para que un golpe caiga en el momento y el sitio correctos. La diferencia entre fotogramas vecinos también entra como movimiento.
ShiftNCE solo se usa al entrenar. Un Synchformer congelado puntúa si el sonido cayó en el instante que debía. Después del entrenamiento, la generación no lo carga. En las ablaciones previas al ajuste fino, quitar ShiftNCE pasó el DeSync de 0.831 a 1.067 en 4096 clips de 10 segundos. Quitar los fotogramas que van directo a la cabeza de generación saltó el FAD de 2.42 a 15.82. Cambiar el fragmento a 33 milisegundos o a 200 dio FAD 3.79 y 2.51. La versión publicada usa 100 milisegundos. Esas cifras son la ablación, no la tabla final de abajo.
Puntuaciones y ejemplos
Miramos sobre todo el FAD VGGish: qué tan lejos queda el sonido generado del de referencia. Más bajo es mejor. En la Tabla 1 del artículo, WorldSonus obtiene 1.73 en VGGSound de estéreo claro a 5 segundos y 2.03 en el conjunto Interactive de 30 segundos.
Modelo | Cómo escribe | FAD, VGGSound estéreo claro a 5 s | FAD, vídeo interactivo a 30 s |
|---|---|---|---|
WorldSonus | Ve y escribe, fragmentos de 100 ms, 41.2 ms en una H100 | 1.73 | 2.03 |
PrismAudio | Primero ve el vídeo entero y el texto | 2.09 | 6.08 |
ThinkSound | Primero ve el vídeo entero y el texto | 2.94 | 7.00 |
AudioX | Primero ve el vídeo entero y el texto | 3.00 | 5.52 |
V-AURA | Mono en flujo, fragmentos de 640 ms | 4.06 | 13.33 |
El conjunto de 5 segundos tiene 4096 clips. El de 30 segundos tiene 1024. El FAD usa el canal central. Los números salen de la Tabla 1 del artículo de WorldSonus.
El tempo todavía no es lo más sólido
No gana todas las columnas. En VGGSound de 5 segundos, el DeSync de WorldSonus es 0.686. ThinkSound es 0.481 y PrismAudio es 0.539: ambos pegan más a la imagen. AudioX es 0.986. V-AURA es 1.287. Sacar el sonido al momento y clavarlo al fotograma todavía tiran en direcciones distintas.
Posición izquierda-derecha, y cambiar la instrucción a mitad
En Interactive de 30 segundos, el BiasSkill de WorldSonus es 15.90. PrismAudio es 4.19, ThinkSound es 0.63, AudioX es −0.01. Tras cambiar la instrucción, el acierto de doble pie de foto es 25.68% en VGGSound y 23.44% en Interactive. Frente a dejar la instrucción original, la ganancia es de unos 0.051 y 0.053.
Cómo lo oye la gente
Veinte personas oyeron 40 clips de 10 segundos e hicieron 400 comparaciones por pares. Prefirieron WorldSonus el 58.8% de las veces frente a AudioX, el 80.0% frente a ThinkSound y el 65.0% frente a PrismAudio. La grabación real sigue ganando. Todo este audio está generado. Nada es una grabación de campo.
Siete ejemplos
Un clip de cada grupo de la página del proyecto, el primero del grupo. Siete en total.
Artículo, código y pesos
El artículo, el código de inferencia y los pesos son públicos. En Studio todavía no hay un botón para esto. Para ejecutarlo, hay que armar el entorno según el proyecto. El artículo y la ficha del modelo no ponen precio ni un servicio comercial.
Artículo en arXiv — arXiv:2610.08760, 6 de octubre de 2026. También hay una edición HTML.
Code — código de inferencia. Con
--stream, en cuanto hay tres fotogramas escribe los siguientes 100 milisegundos de audio.Weights —
worldsonus_150k.pt(C3 no-H0 final, 150k EMA, 638 tensores de inferencia),audio_codec.pt(decodificador estéreo causal a 48 kHz, 30 Hz, 64 canales) yz_stats.pt. DINOv3 y T5Gemma 2 se bajan aparte, cada uno con su licencia.
El código del proyecto y estos pesos son CC BY-NC 4.0: hay que atribuir y el uso es solo no comercial. Antes de un uso comercial, hay que aclarar la licencia.
El comando base de la ficha es:
python -m worldsonus.infer --video input.mp4 --prompt "A train passes beside a river." --output output.wav
Con --stream escribe de a 100 milisegundos. El README dice que el código público no promete una latencia fija. 41.2 milisegundos es solo la medida del artículo en una H100.
Hasta dónde se puede usar ahora
La ficha lo dice claro: es una versión de inferencia de investigación, no un sistema en directo ya en producción. El código de entrenamiento y los datos de entrenamiento no vienen en el paquete. El códec de audio es la versión causal pública de SoundReactor. El artículo también dice que su reconstrucción es más débil que la del decodificador no causal de SoundReactor.
El sonido generado puede omitir sucesos de la imagen. También puede llevar artefactos. No lo tomes por una grabación, y menos por una prueba. Si aparece una voz reconocible, hace falta permiso antes.
Dos cosas que aún no están listas
El artículo señala dos huecos. Uno es un códec de audio causal mejor: seguir escribiendo sonido al decodificar, y conservar más detalle. El otro es un conjunto más limpio de estéreo espacial. En los datos públicos, a veces el supuesto estéreo es mono copiado, o se ensució al separar los canales. Para que el sonido siga a las personas y a la cámara, todavía falta audio espacial más fiable.