我们发布了 WorldSonus。世界模型还在一段段生成画面时,它可以同时配上立体声:画面出来一段,声音就跟着来一段。
每一段是 100 毫秒的 48 kHz 立体声。论文在一张 NVIDIA H100 上测过,生成一段要 41.2 毫秒,实时因子是 0.41。论文、代码和权重都公开了。Noiz Studio 里还没有这个功能。
世界模型通常是静音的
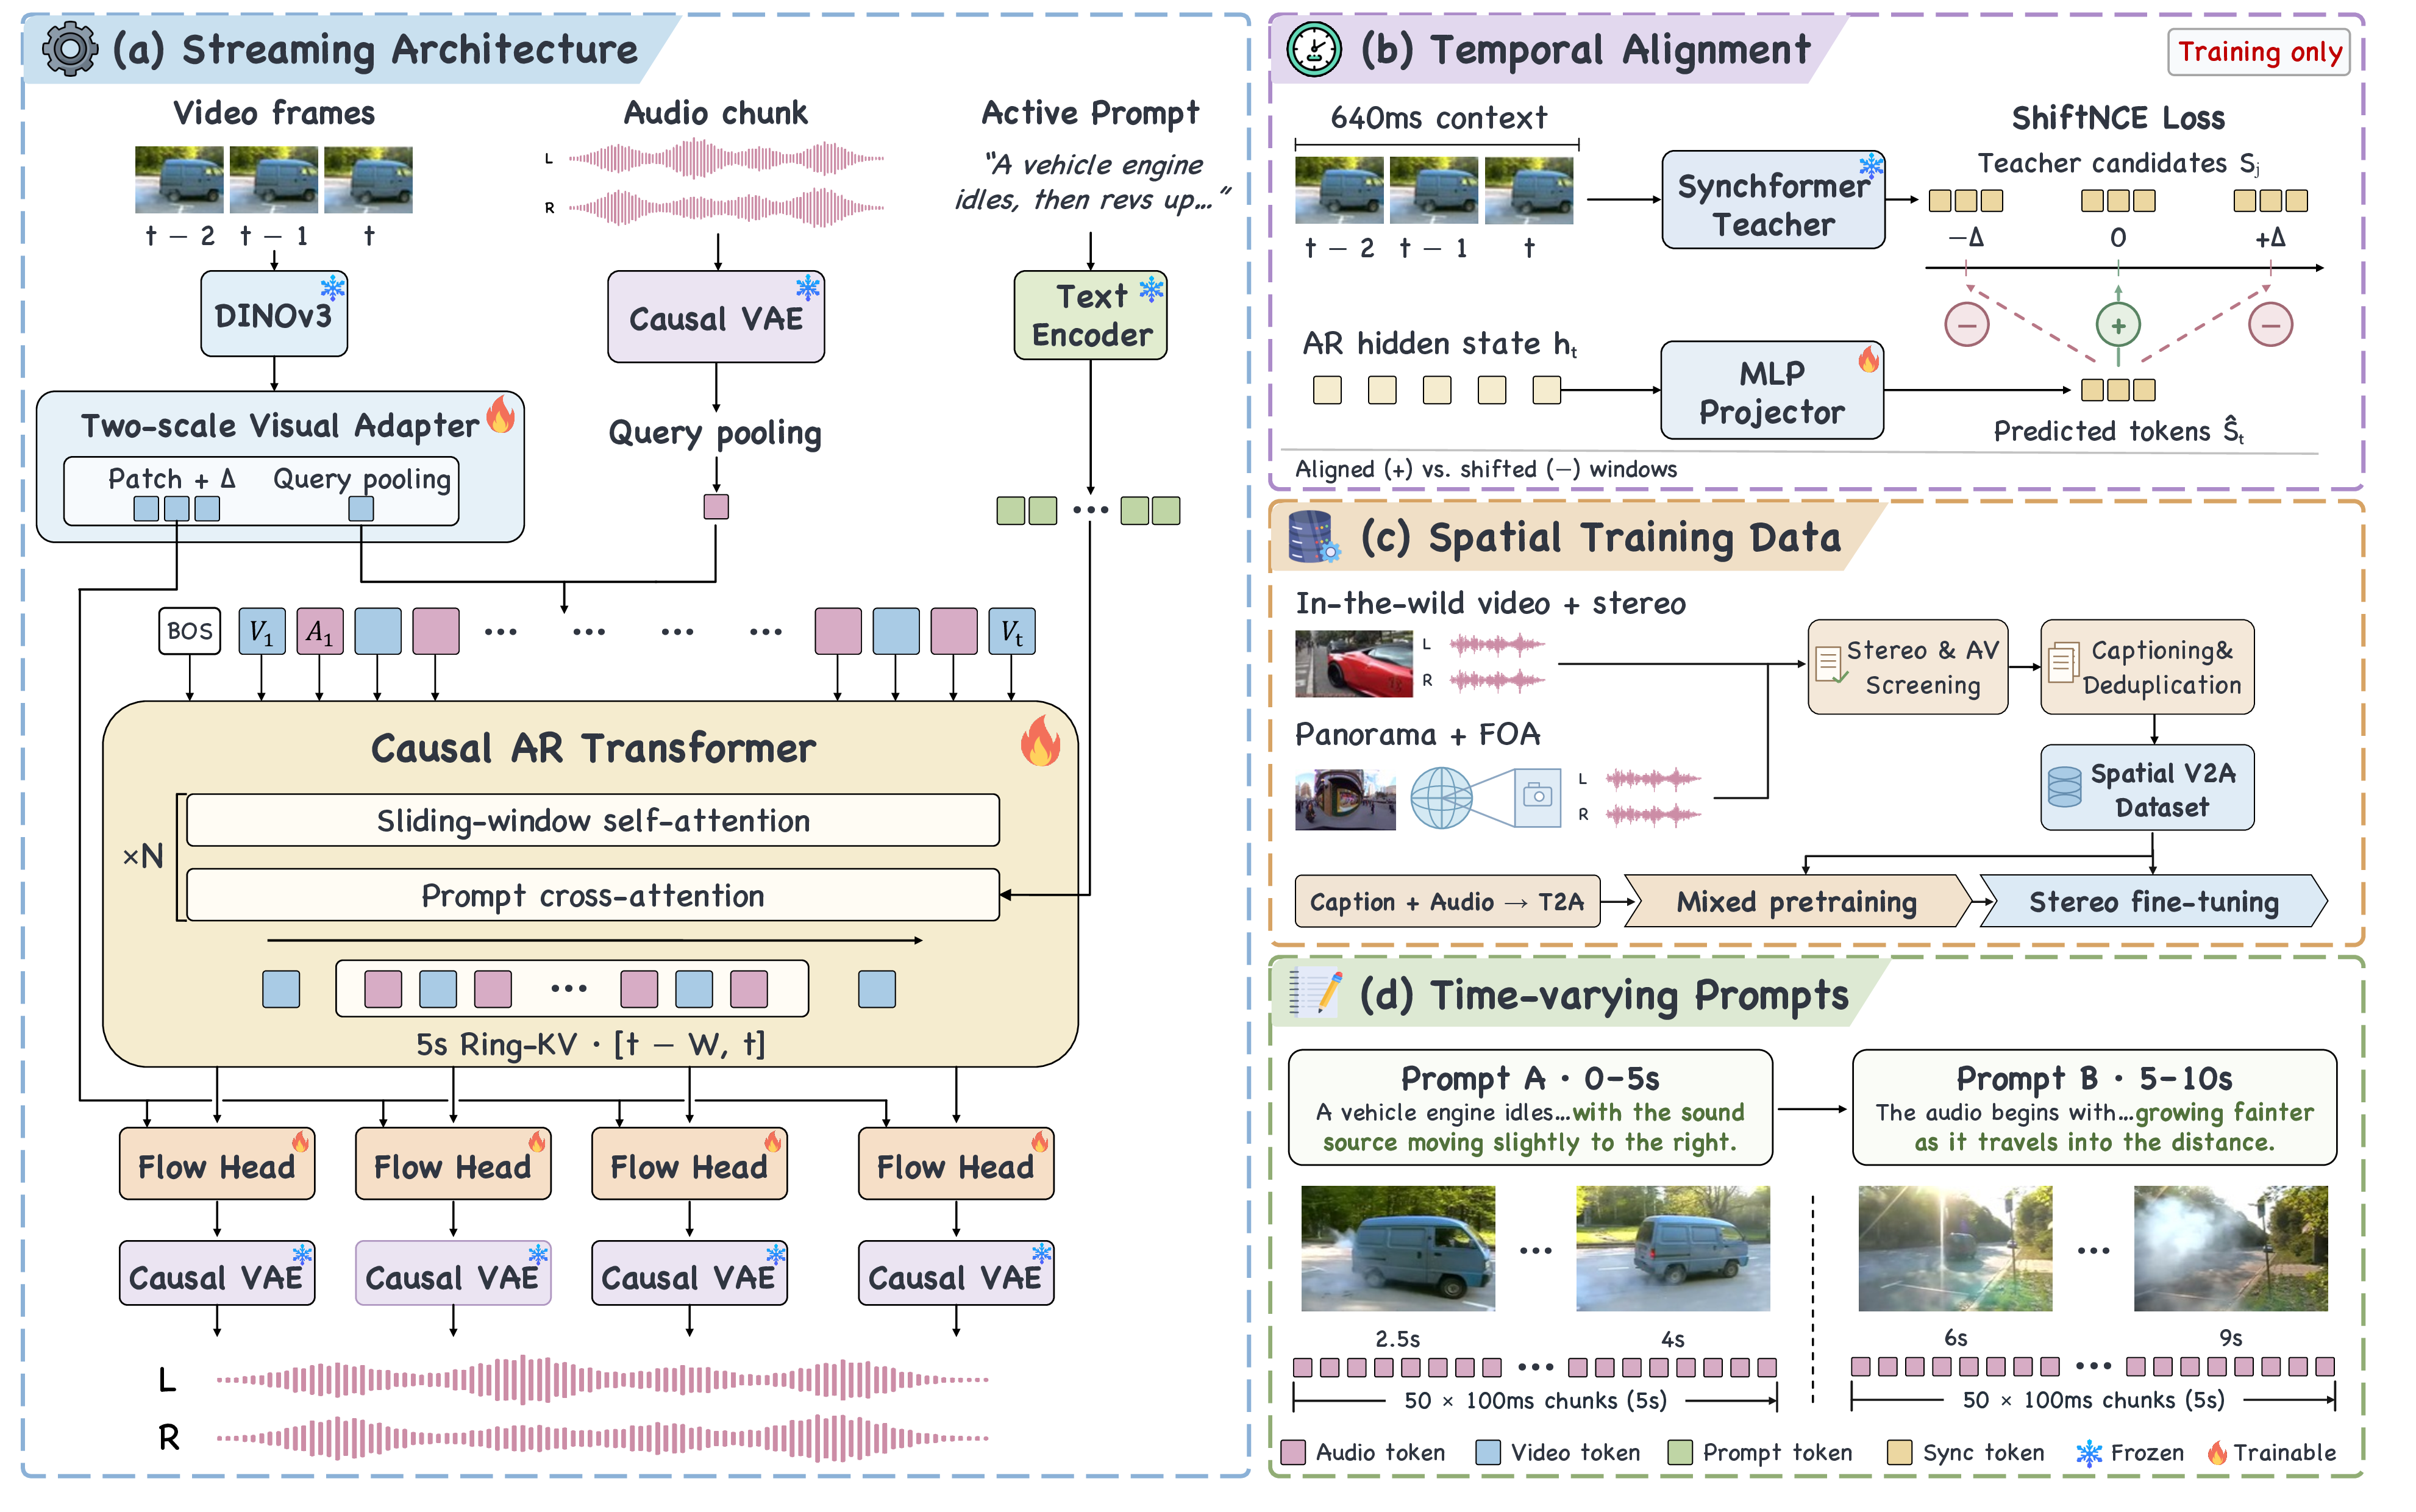
世界模型能连续生成一个环境,但交出来的往往只有画面。WorldSonus 接在后面补声音。它只看已经生成的帧,再加上你现在给的声音提示,然后生成下一段左右声道。后面还没出来的帧,它看不见。
作者来自香港科技大学、Noiz、MetaX 和上海交通大学。通讯作者是 Zeyue Tian 和 Qifeng Chen,完整名单在论文里。
声音怎么跟上画面
它不等整段视频做完。画面走到哪,声音就跟到哪。
一次只做 100 毫秒
每一段是 100 毫秒的 48 kHz 立体声,正好对上 30 帧视频里的三帧。内部的立体声编码器也按 30 Hz 走,所以一段声音对应三个内部帧。
模型只记住最近 5 秒,也就是 50 段。满了就丢掉最早那段,视频再长,占用也不会一直涨。
做到一半可以改提示
想换一种声音,等到下一个 100 毫秒切一下就行。已经生成的部分留下,前面的画面也不重算。训练用的 10 秒样本里,有 60% 会在第 5 秒换提示。
左右耳跟着镜头
出来的是跟着透视相机走的左右声道,不是把单声道复制两遍。训练用了 1465 小时音频:999 小时是带立体声的视频,466 小时只有声音。立体声来自两类数据,一类是筛过的真实录音,一类是把全景环绕声转到相机视角的音频。
前面的视频模型只要把已经生成的帧递过来,不用开放内部状态。SwanSphere 做的是全景视频和环绕声;WorldSonus 做的是普通镜头里的实时立体声。
画面分两路看
DINOv3 负责读画面。一路做成稍长一点的摘要,帮模型把声音事件接住;另一路把这三帧分别送进生成头,好让某个响动落在对的时间和位置。相邻两帧差在哪,也会当成运动信息。
ShiftNCE 只在训练时用。一个冻住的 Synchformer 负责打分:声音有没有落在该响的那一瞬。学完之后,真正生成时不用再加载它。微调前的对照实验里,拿掉 ShiftNCE,4096 条 10 秒片段的 DeSync 从 0.831 变成 1.067;拿掉直接送进生成头的那路帧特征,FAD 从 2.42 跳到 15.82。块长改成 33 毫秒或 200 毫秒,FAD 分别是 3.79 和 2.51。正式发布用 100 毫秒。这几组是对照实验,不是后面表格里的最终成绩。
分数和样例
我们主要看 VGGish FAD:生成的声音和参考声音差多远,数字越小越好。论文 Table 1 里,WorldSonus 在 5 秒清晰立体声 VGGSound 上是 1.73,在 30 秒 Interactive 集合上是 2.03。
模型 | 怎么生成 | FAD,5 秒清晰立体声 VGGSound | FAD,30 秒交互视频 |
|---|---|---|---|
WorldSonus | 边看边生成,100 毫秒一段,单张 H100 上 41.2 毫秒 | 1.73 | 2.03 |
PrismAudio | 先看完整段视频和文字 | 2.09 | 6.08 |
ThinkSound | 先看完整段视频和文字 | 2.94 | 7.00 |
AudioX | 先看完整段视频和文字 | 3.00 | 5.52 |
V-AURA | 流式单声道,640 毫秒一段 | 4.06 | 13.33 |
5 秒集合有 4096 条,30 秒集合有 1024 条。FAD 用的是中置声道。数字来自 WorldSonus 论文 Table 1。
对拍子还不是最稳
不是每项都第一。5 秒 VGGSound 上,WorldSonus 的 DeSync 是 0.686。ThinkSound 是 0.481,PrismAudio 是 0.539,都更贴画面。AudioX 是 0.986,V-AURA 是 1.287。一边要马上出声,一边还要把声音卡在画面上,这两件事现在还在拉扯。
左右位置,以及中途改提示
30 秒 Interactive 上,WorldSonus 的 BiasSkill 是 15.90。PrismAudio 是 4.19,ThinkSound 是 0.63,AudioX 是 −0.01。提示中途换掉之后,VGGSound 和 Interactive 上的双 caption 匹配率是 25.68% 和 23.44%;比起一直用原来的提示,增益大约是 0.051 和 0.053。
人怎么听
20 个人听了 40 条 10 秒片段,一共做了 400 次两两对比。比起 AudioX,58.8% 的时候更喜欢 WorldSonus;比起 ThinkSound 是 80.0%,比起 PrismAudio 是 65.0%。真录音仍然赢。这些都是模型生成的,不是现场录的。
七条样例
项目页每组取第一条,一共 7 条。
论文、代码和权重
论文、推理代码和权重都公开了。Studio 里还没有这个按钮。要自己跑,得按项目说明搭环境。价格和商业服务,论文和模型卡都没写。
Code — 推理代码。加上
--stream,每凑齐三帧就吐出下一段 100 毫秒音频。Weights —
worldsonus_150k.pt(最终 C3 no-H0、150k EMA,638 个推理张量)、audio_codec.pt(30 Hz、64 通道的因果 48 kHz 立体声解码器)和z_stats.pt。DINOv3 和 T5Gemma 2 要按各自许可另外下。
项目代码和这套权重是 CC BY-NC 4.0:要署名,且只能非商用。想商用,得先把许可问清楚。
模型卡里的基础命令是:
python -m worldsonus.infer --video input.mp4 --prompt "A train passes beside a river." --output output.wav
加上 --stream 就按 100 毫秒往外吐。README 写了,公开代码不保证固定延迟。41.2 毫秒只是论文在一张 H100 上测到的。
现在能用到哪一步
模型卡写得很清楚:这是研究用的推理版本,不是已经上线的直播系统。训练代码和训练数据没有一起发。音频编解码器用的是 SoundReactor 公开的因果版本;论文也说了,它的重建质量不如 SoundReactor 那个非因果解码器。
生成的声音可能漏掉画面里的事件,也可能有伪影。别把它当录音,更别当证据。如果里面有能认出来的人声,得先有授权。
还没做完的两件事
论文自己点了两个缺口。一是更好的因果音频编解码器:边解边出声这件事要留着,细节还得更好。二是更干净的空间立体声数据。现在公开数据里,有些所谓立体声其实是单声道复制出来的,或者声道拆开时弄脏了。想让声音跟着人和镜头走,还缺更靠谱的空间音频。