WorldSonus を公開します。ワールドモデルがまだ絵を一段ずつ出しているあいだに、ステレオを同時に付けられます。絵が出たら、音もその分だけついてきます。
1チャンクは 100ミリ秒の 48 kHz ステレオです。論文は NVIDIA H100 1枚で、このチャンクの生成に 41.2 ミリ秒かかると測っています。実時間係数は 0.41 です。論文、コード、重みは公開済みです。Noiz Studio には、まだ入っていません。
ワールドモデルはたいてい無音だ
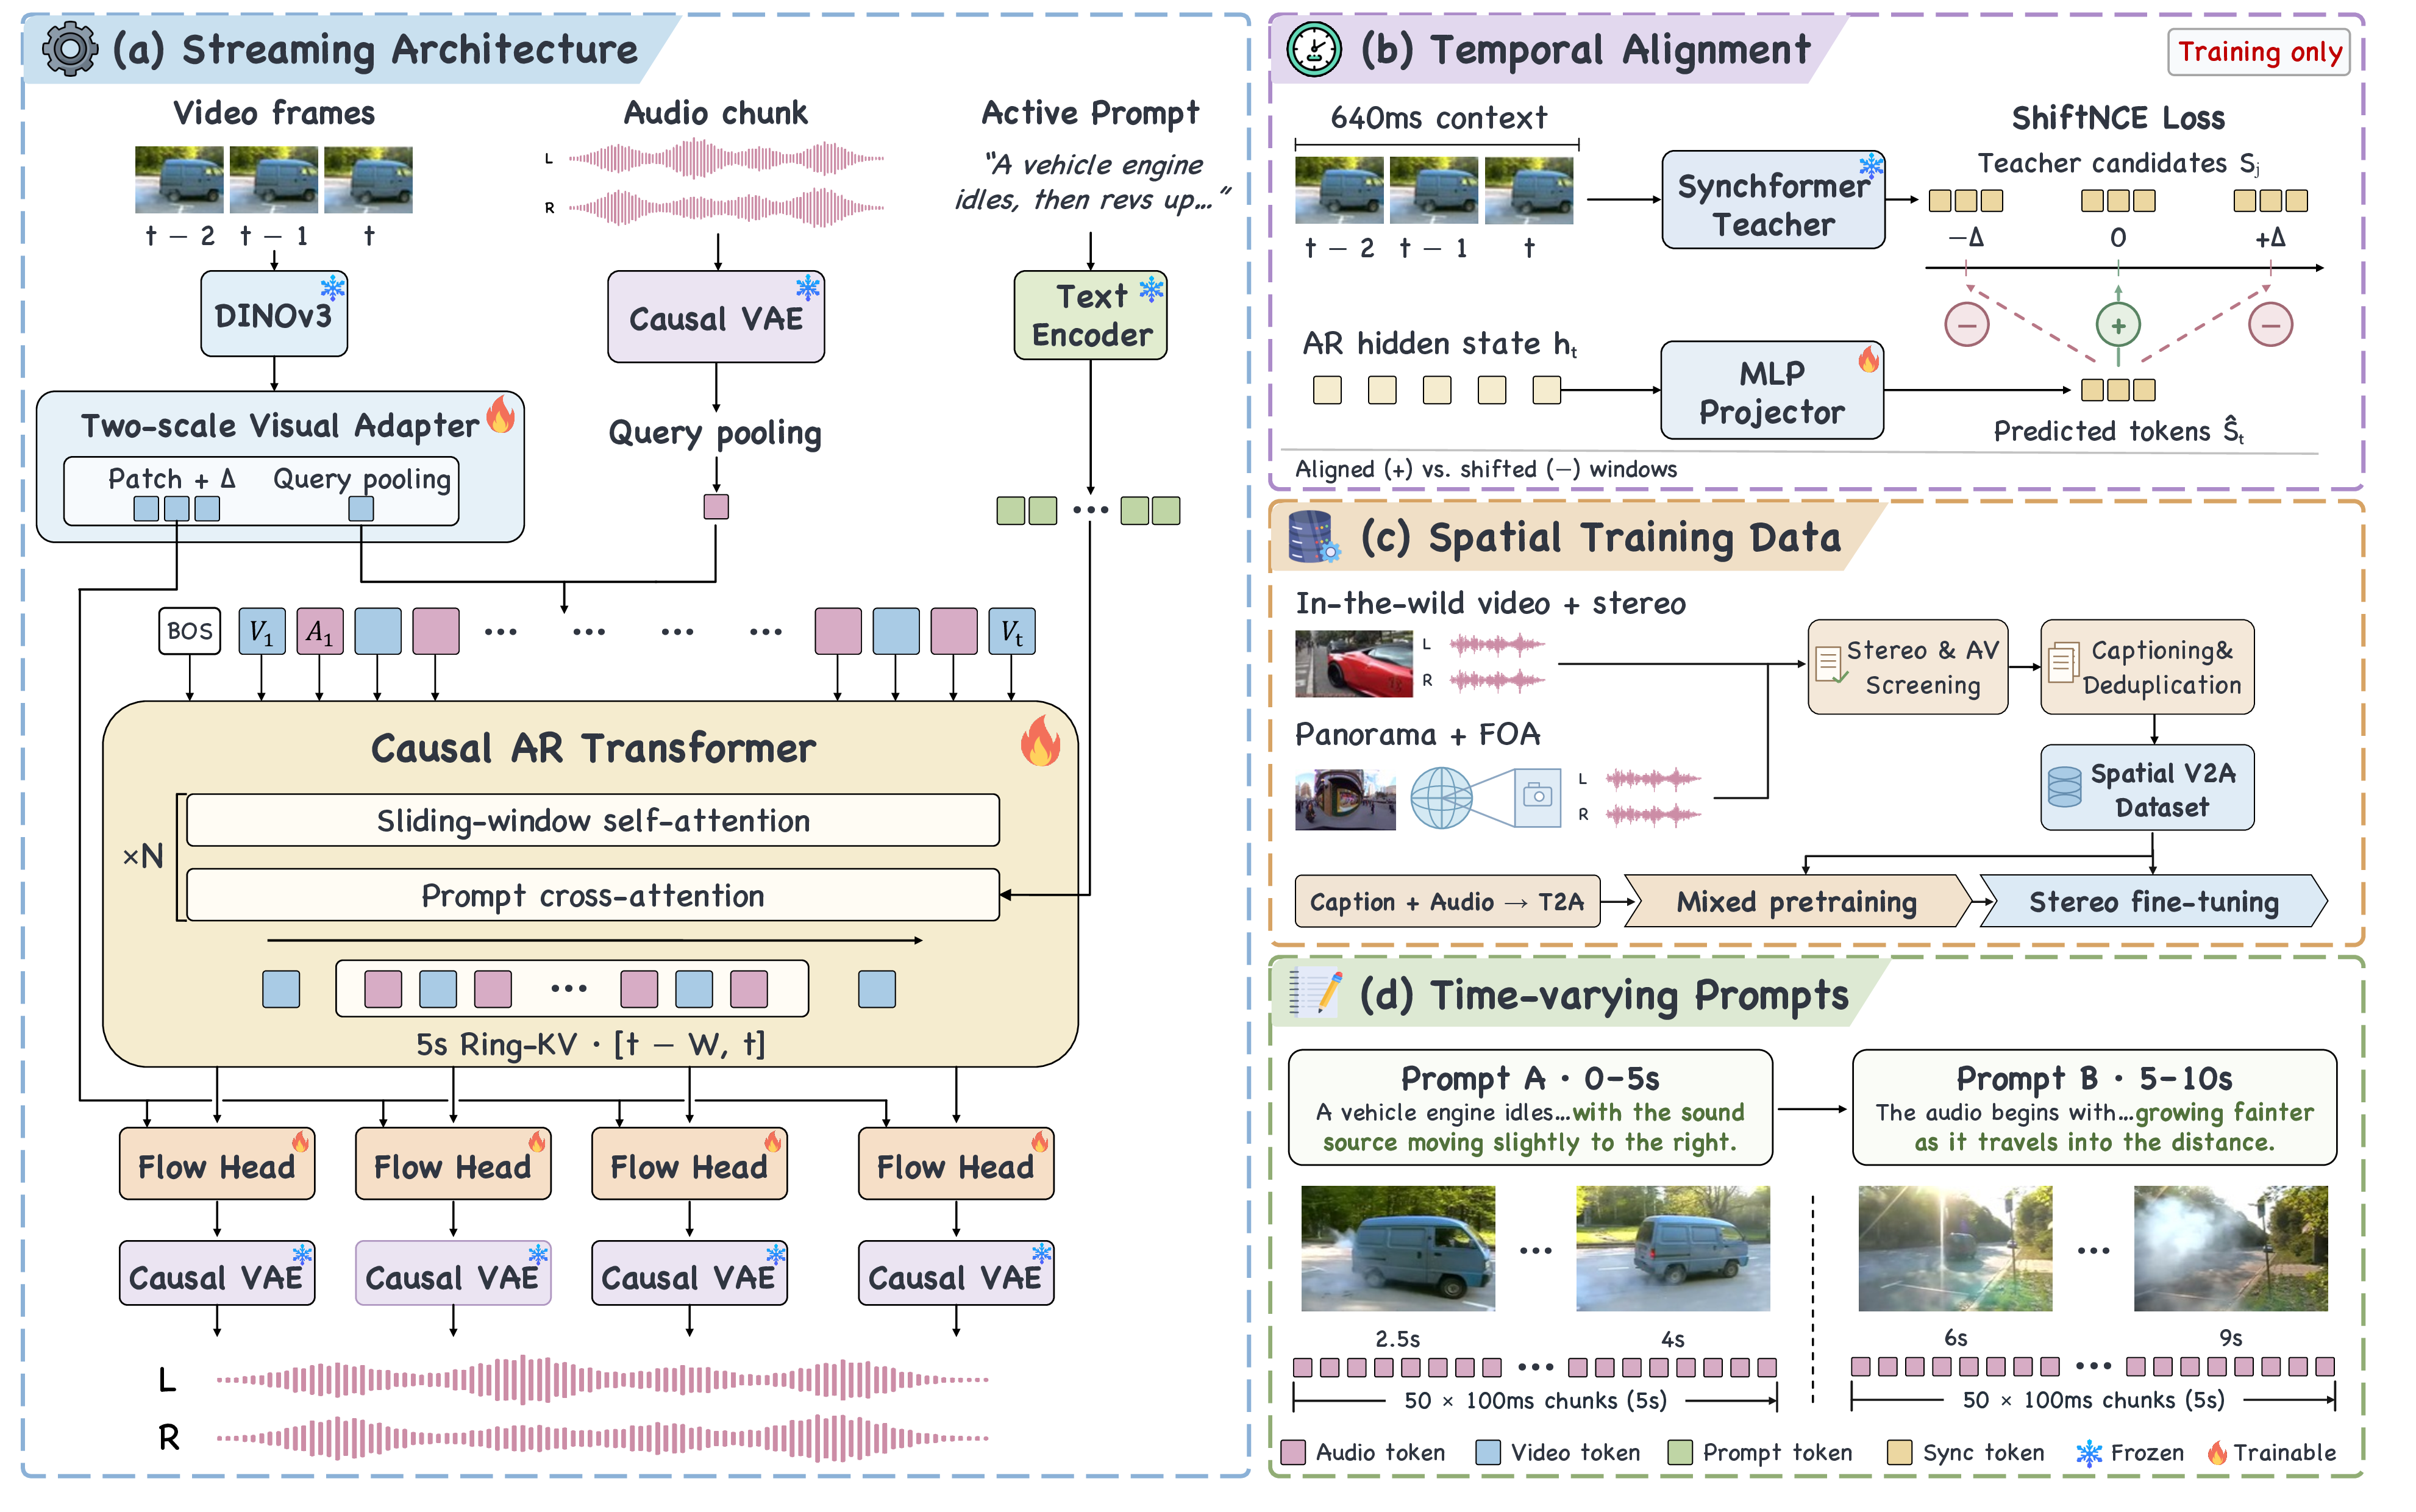
ワールドモデルは環境を連続して出せますが、渡ってくるのは絵だけのことが多いです。WorldSonus はその後ろに付いて、音を補います。すでに出たフレームと、いま渡した音の指示だけを見て、次の左右チャンネルを書きます。まだ出ていないフレームは見えません。
著者は香港科技大学、Noiz、MetaX、上海交通大学です。責任著者は Zeyue Tian と Qifeng Chen です。全員の名前は論文にあります。
音はどうやって絵に追いつくか
映像が全部終わるのを待ちません。絵がどこまで進んだか、音もそこまで付きます。
一度に100ミリ秒だけ
1チャンクは 100ミリ秒の 48 kHz ステレオです。30フレームの映像なら、ちょうど3枚分です。内部のステレオ符号器も 30 Hz で動くので、音の1チャンクは内部フレーム3枚に対応します。
モデルが覚えるのは直近5秒、つまり50チャンクだけです。一杯になると一番古い枠を捨てます。尺が伸びても、メモリは増え続けません。
途中で指示を変えられる
音を変えたいときは、次の100ミリ秒まで待って切り替えます。すでに書いた分は残ります。前のフレームも計算し直しません。学習に使った10秒の例では、60% が5秒の地点で指示を変えます。
左右の耳はカメラについていく
出てくるのは、透視カメラに沿った左右チャンネルです。モノラルを二回コピーしたものではありません。学習音声は 1465 時間です。999 時間はステレオ付きの映像、466 時間は音だけです。ステレオは二種類で、選別した実録音と、全天球のサラウンドをカメラ視点へ折った音です。
前段の映像モデルは、描き終えたフレームを渡せば足ります。内部状態を開く必要はありません。SwanSphere はパノラマ映像とサラウンドです。WorldSonus は、普通のレンズ向けのリアルタイムステレオです。
絵は二系統で見る
DINOv3 が絵を読みます。一方は少し長い要約にして、音の出来事を繋ぎ止めます。もう一方は、この3フレームを生成ヘッドへ直接入れ、鳴りが正しい時刻と位置に落ちるようにします。隣り合うフレームの差も、動きとして使います。
ShiftNCE は学習時だけです。凍らせた Synchformer が、音が鳴るべき一瞬に落ちたかを採点します。学び終われば、生成時に載せる必要はありません。微調整前の対照実験では、ShiftNCE を外すと、10秒クリップ 4096 本の DeSync が 0.831 から 1.067 になりました。生成ヘッドへ直接入れるフレーム経路を切ると、FAD は 2.42 から 15.82 へ跳ねます。チャンクを 33ミリ秒や 200ミリ秒にすると、FAD はそれぞれ 3.79 と 2.51 です。公開版は 100ミリ秒です。これは対照実験の数字で、下の最終表ではありません。
点数とサンプル
主に見るのは VGGish FAD です。生成した音が参照音からどれだけ離れているかで、小さいほど近い。論文の Table 1 では、WorldSonus は5秒の明瞭ステレオ VGGSound で 1.73、30秒の Interactive 集合で 2.03 です。
モデル | 書き方 | FAD、5秒の明瞭ステレオ VGGSound | FAD、30秒のインタラクティブ映像 |
|---|---|---|---|
WorldSonus | 見ながら書く、100ミリ秒ごと、H100 1枚で 41.2 ミリ秒 | 1.73 | 2.03 |
PrismAudio | 先に映像とテキストを全部見る | 2.09 | 6.08 |
ThinkSound | 先に映像とテキストを全部見る | 2.94 | 7.00 |
AudioX | 先に映像とテキストを全部見る | 3.00 | 5.52 |
V-AURA | ストリームのモノラル、640ミリ秒ごと | 4.06 | 13.33 |
5秒集合は 4096 本、30秒集合は 1024 本です。FAD はミッドチャンネルです。数字は WorldSonus 論文の Table 1 です。
拍の合わせはまだ一番強くない
全部で一位、というわけではありません。5秒 VGGSound の DeSync は、WorldSonus が 0.686 です。ThinkSound は 0.481、PrismAudio は 0.539 で、どちらも絵により密着しています。AudioX は 0.986、V-AURA は 1.287 です。すぐ音を出すことと、絵に音を貼ること。この二つは、まだ引っ張り合っています。
左右の位置と、途中の指示変更
30秒 Interactive では、WorldSonus の BiasSkill は 15.90 です。PrismAudio は 4.19、ThinkSound は 0.63、AudioX は −0.01 です。途中で指示を変えたあと、二本のキャプションへの一致率は VGGSound で 25.68%、Interactive で 23.44% です。元の指示のままにしたときと比べた増分は、およそ 0.051 と 0.053 です。
人はどう聴くか
20人が、10秒クリップ 40本を聴き、400回の一対比較をしました。AudioX より WorldSonus を選んだのは 58.8%、ThinkSound よりは 80.0%、PrismAudio よりは 65.0% です。本物の録音は、それでも勝ちます。ここにある音は、すべて生成です。現場録音ではありません。
七本のサンプル
プロジェクトページの各グループから、先頭の1本。全部で7本です。
論文、コード、重み
論文、推論コード、重みは公開しています。Studio には、まだこのボタンがありません。自分で動かすには、プロジェクトの手順で環境を組む必要があります。価格や商用サービスは、論文にもモデルカードにも書いてありません。
Code — 推論コード。
--streamを付けると、フレームが3枚揃った時点で次の100ミリ秒の音を出します。Weights —
worldsonus_150k.pt(最終 C3 no-H0、150k EMA、推論テンソル 638 個)、audio_codec.pt(30 Hz、64チャンネルの因果 48 kHz ステレオデコーダ)、z_stats.pt。DINOv3 と T5Gemma 2 は、それぞれの許諾で別に落とします。
プロジェクトのコードとこの重みは CC BY-NC 4.0 です。帰属表示が必要で、非商用に限ります。商用に使うなら、先に許諾を確かめてください。
モデルカードの基本コマンドは次です。
python -m worldsonus.infer --video input.mp4 --prompt "A train passes beside a river." --output output.wav
--stream を付けると、100ミリ秒ずつ出します。README には、公開コードが固定遅延を保証しないと書いてあります。41.2 ミリ秒は、論文が H100 1枚で測った値です。
いま使える範囲
モデルカードははっきり書いています。これは研究用の推論リリースで、すでに動いている配信システムではありません。学習コードと学習データは同梱されていません。音声コーデックは、SoundReactor が公開した因果版です。論文も、その再構成は SoundReactor の非因果デコーダより弱いと言っています。
生成音は、絵の出来事を外すことがあります。アーティファクトが乗ることもあります。録音だと思わないでください。証拠にもしないでください。聞き分けられる人の声が入っているなら、先に許諾が要ります。
まだ残っている二つ
論文自身が、二つの穴を挙げています。一つは、より良い因果音声コーデックです。解きながら音を出すことは残したまま、細部をもっと良くしたい。もう一つは、きれいな空間ステレオデータです。いまの公開データには、ステレオと書いてあってもモノラルのコピーだったり、チャンネルを分けたときに汚れていたりするものがあります。人とカメラについていく音には、もっと確かな空間音が足りません。